

Obtén información para optimizar la métrica Tiempo hasta el primer byte.

Fecha de publicación: 19 de enero de 2023; última actualización: 28 de noviembre de 2025
El Time to First Byte (TTFB) es una métrica de rendimiento web fundamental que precede a cualquier otra métrica de experiencia del usuario significativa, como el First Contentful Paint (FCP) y el Largest Contentful Paint (LCP). Esto significa que los valores altos de TTFB agregan tiempo a las métricas que le siguen.
Se recomienda que tu servidor responda a las solicitudes de navegación con la rapidez suficiente para que el percentil 75 de los usuarios experimente un FCP dentro del umbral "bueno". Como guía general, la mayoría de los sitios deberían esforzarse por tener un TTFB de 0.8 segundos o menos.

Cómo medir el TTFB
Antes de optimizar el TTFB, debes observar cómo afecta a los usuarios de tu sitio web. Debes confiar en los datos de campo como fuente principal para observar el TTFB, ya que se ve afectado por los redireccionamientos, mientras que las herramientas basadas en el lab suelen medirse con la URL final, por lo que se pierde este retraso adicional.
PageSpeed Insights es una forma de obtener información de campo y de laboratorio para los sitios web públicos que están disponibles en el Chrome User Experience Report.
El TTFB para usuarios reales se muestra en la sección superior Descubre qué experimentan tus usuarios reales:

En el caso de los datos de lab, los problemas de TTFB se muestran en la estadística Latencia de la solicitud de documento:
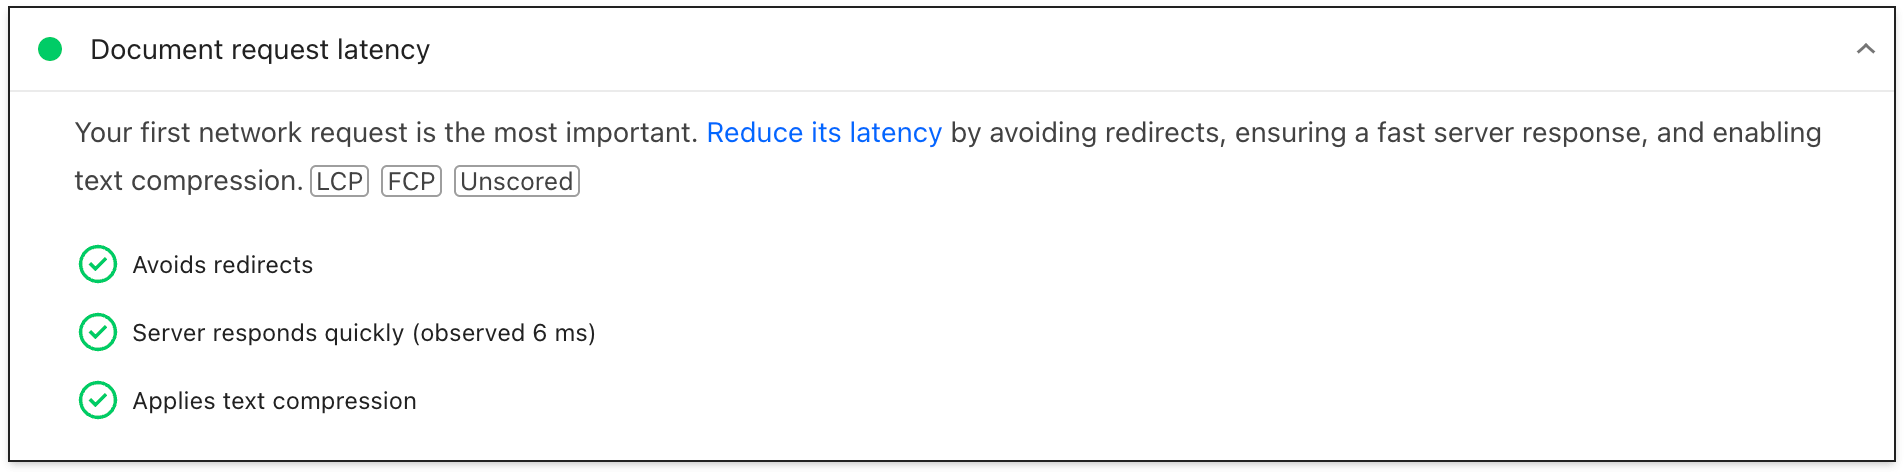
Para conocer más formas de medir el TTFB tanto en el campo como en el lab, consulta la página de la métrica TTFB.
Comprende las diferencias entre el TTFB de campo y el de lab
El TTFB de laboratorio y de campo puede diferir por varios motivos y, cuando lo hace, es importante comprender por qué para poder usar los datos de laboratorio de manera eficaz y mejorar las experiencias de los usuarios.
Cuando el TTFB de laboratorio es mucho mayor que el TTFB de campo, esto indica que el entorno de laboratorio está más restringido que las experiencias típicas de los usuarios. Esto no es necesariamente un problema, ya que los resultados y las recomendaciones del lab siguen siendo válidos, pero pueden exagerar el impacto y la mejora.
Cuando el TTFB de campo es mucho mayor que el TTFB de lab, esto indica problemas que no son evidentes en la ejecución del lab, como el uso de almacenamiento en caché del servidor, redireccionamientos o diferencias de red. En este caso, los resultados y las recomendaciones del lab pueden ser menos útiles, ya que no se incluye uno de los problemas principales.
Para ver si el almacenamiento en caché del servidor afecta el TTFB de laboratorio, prueba páginas menos comunes o usa diferentes parámetros de URL para obtener contenido no almacenado en caché y ver si el TTFB está más en línea con el TTFB de campo. También puede ser útil que puedas omitir el almacenamiento en caché del servidor con un parámetro de URL específico. Consulta la sección de contenido almacenado en caché.
En el caso de los redireccionamientos y las diferencias de red, las estadísticas sobre cómo llega el tráfico a nuestro sitio y de dónde proviene pueden ser útiles para diagnosticar si se trata de problemas potenciales.
Depura el TTFB alto en el campo con Server-Timing
El encabezado de respuesta Server-Timing se puede usar en el backend de tu aplicación para medir distintos procesos de backend que podrían contribuir a una latencia alta. La estructura del valor del encabezado es flexible y acepta, como mínimo, un identificador que definas. Los valores opcionales incluyen un valor de duración (a través de dur), así como una descripción opcional legible por humanos (a través de desc).
Serving-Timing se puede usar para medir muchos procesos de backend de la aplicación, pero hay algunos a los que tal vez quieras prestar especial atención:
- Consultas en bases de datos
- Tiempo de renderización del servidor, si corresponde
- Búsquedas en disco
- Aciertos o errores de caché del servidor perimetral (si se usa una CDN)
Todas las partes de una entrada Server-Timing se separan con dos puntos, y las entradas múltiples se pueden separar con una coma:
// Two metrics with descriptions and values
Server-Timing: db;desc="Database";dur=121.3, ssr;desc="Server-side Rendering";dur=212.2
El encabezado se puede configurar con el lenguaje de backend de tu aplicación que elijas. En PHP, por ejemplo, puedes configurar el encabezado de la siguiente manera:
<?php
// Get a high-resolution timestamp before
// the database query is performed:
$dbReadStartTime = hrtime(true);

// Perform a database query and get results...
// ...

// Get a high-resolution timestamp after
// the database query is performed:
$dbReadEndTime = hrtime(true);

// Get the total time, converting nanoseconds to
// milliseconds (or whatever granularity you need):
$dbReadTotalTime = ($dbReadEndTime - $dbReadStartTime) / 1e+6;

// Set the Server-Timing header:
header('Server-Timing: db;desc="Database";dur=' . $dbReadTotalTime);
?>
Cuando se configura este encabezado, se muestra información que puedes usar tanto en el lab como en el campo.
En el campo, cualquier página con un encabezado de respuesta Server-Timing establecido propaga la propiedad serverTiming en la API de Navigation Timing:
// Get the serverTiming entry for the first navigation request:
performance.getEntries('navigation')[0].serverTiming.forEach(entry => {
  // Log the server timing data:
  console.log(entry.name, entry.description, entry.duration);
});
En el lab, los datos del encabezado de respuesta Server-Timing se visualizan en el panel Tiempos de la pestaña Red en las Herramientas para desarrolladores de Chrome:

Aquí, Server-Timing se usa para medir si una solicitud de un recurso llegó a la caché de la CDN y cuánto tiempo tarda la solicitud en llegar al servidor perimetral de la CDN y, luego, al origen.
Los tiempos del servidor también se muestran en la pista de red del panel Rendimiento de las Herramientas para desarrolladores de Chrome:
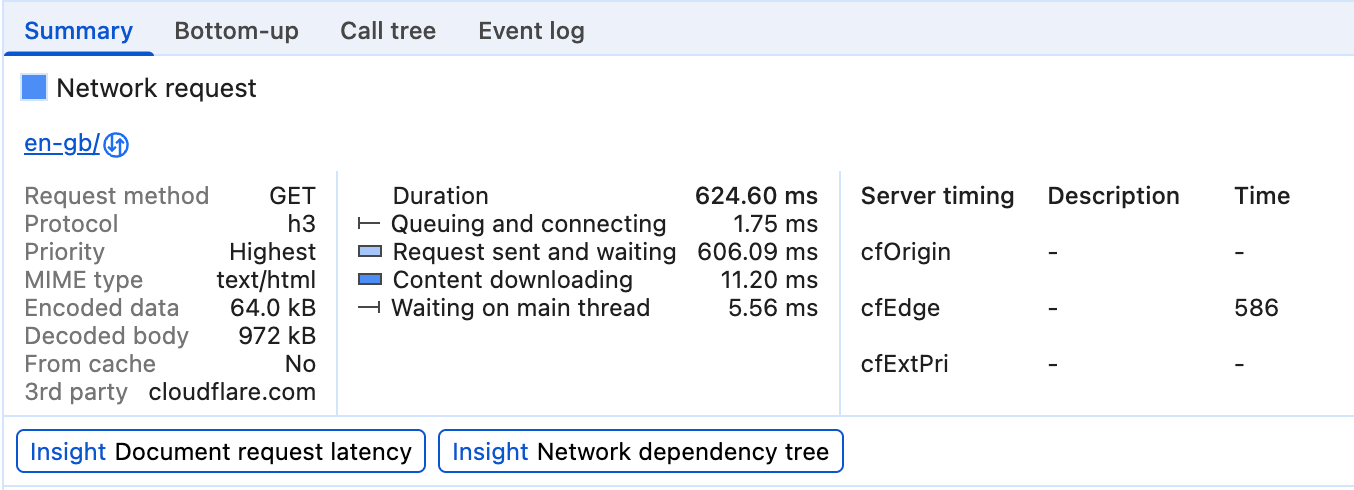
Una vez que hayas determinado que tienes un TTFB problemático analizando los datos disponibles, puedes pasar a solucionar el problema.
Formas de optimizar el TTFB
El aspecto más desafiante de optimizar el TTFB es que, si bien la pila de frontend de la Web siempre es HTML, CSS y JavaScript, las pilas de backend pueden variar de forma significativa. Existen numerosas pilas de backend y productos de bases de datos, cada uno con sus propias técnicas de optimización. Por lo tanto, esta guía se enfoca en lo que se aplica a la mayoría de las arquitecturas, en lugar de enfocarse solo en la orientación específica de la pila.
Orientación específica para cada plataforma
La plataforma que usas para tu sitio web puede tener un gran impacto en el TTFB. Por ejemplo, el rendimiento de WordPress se ve afectado por la cantidad y la calidad de los complementos, o por los temas que se usan. Otras plataformas se ven afectadas de manera similar cuando se personalizan. Debes consultar la documentación de tu plataforma para obtener consejos específicos del proveedor que complementen los consejos de rendimiento más generales de esta publicación. La estadística de Lighthouse también incluye algunas indicaciones limitadas específicas de la pila.
Hosting, hosting, hosting
Antes de considerar otros enfoques de optimización, el hosting debería ser lo primero que tengas en cuenta. No hay mucha orientación específica que se pueda ofrecer aquí, pero una regla general es asegurarse de que el host de tu sitio web sea capaz de controlar el tráfico que le envías.
Por lo general, el hosting compartido es más lento. Si ejecutas un sitio web personal pequeño que entrega principalmente archivos estáticos, es probable que esto sea suficiente. Usa algunas de las siguientes técnicas de optimización para reducir el TTFB lo más posible.
Sin embargo, si ejecutas una aplicación más grande con muchos usuarios que implica personalización, consultas de bases de datos y otras operaciones intensivas del servidor, tu elección de hosting se vuelve fundamental para reducir el TTFB en el campo.
Cuando elijas un proveedor de hosting, ten en cuenta lo siguiente:
- ¿Cuánta memoria se asigna a la instancia de tu aplicación? Si tu aplicación no tiene suficiente memoria, se producirá un intercambio excesivo de páginas y tendrá dificultades para entregar páginas lo más rápido posible.
- ¿Tu proveedor de hosting mantiene actualizada tu pila de backend? A medida que se lanzan nuevas versiones de los lenguajes de backend de las aplicaciones, las implementaciones de HTTP y el software de base de datos, el rendimiento de ese software mejora con el tiempo. Es fundamental asociarse con un proveedor de hosting que priorice este tipo de mantenimiento crucial.
- Si tienes requisitos de aplicación muy específicos y quieres el acceso de nivel más bajo a los archivos de configuración del servidor, pregunta si tiene sentido personalizar el backend de tu propia instancia de aplicación.
Hay muchos proveedores de hosting que se encargan de estos aspectos por ti, pero si comienzas a observar valores de TTFB altos incluso en proveedores de hosting dedicados, puede ser un indicio de que debes volver a evaluar las capacidades de tu proveedor de hosting actual para poder ofrecer la mejor experiencia del usuario posible.
Usa una red de distribución de contenidos (CDN)
El tema del uso de CDN es muy conocido, pero por una buena razón: podrías tener un backend de aplicación muy bien optimizado, pero los usuarios ubicados lejos de tu servidor de origen podrían experimentar un TTFB alto en el campo.
Las CDN resuelven el problema de la proximidad del usuario desde tu servidor de origen usando una red distribuida de servidores que almacenan en caché los recursos en servidores que están físicamente más cerca de tus usuarios. Estos servidores se denominan servidores perimetrales.
Los proveedores de CDN también pueden ofrecer beneficios más allá de los servidores perimetrales:
- Los proveedores de CDN suelen ofrecer tiempos de resolución de DNS extremadamente rápidos.
- Es probable que una CDN entregue tu contenido desde servidores perimetrales con protocolos modernos, como HTTP/2 o HTTP/3.
- En particular, HTTP/3 resuelve el problema de bloqueo de cabecera de línea presente en TCP (en el que se basa HTTP/2) mediante el uso del protocolo UDP.
- Es probable que una CDN proporcione versiones modernas de TLS, lo que reduce la latencia involucrada en el tiempo de negociación de TLS. En particular, TLS 1.3 está diseñado para que la negociación de TLS sea lo más breve posible.
- Algunos proveedores de CDN proporcionan una función que suele llamarse "edge worker", que usa una API similar a la de la API de Service Worker para interceptar solicitudes, administrar de manera programática las respuestas en el almacenamiento en caché perimetral o reescribir las respuestas por completo.
- Los proveedores de CDN son muy buenos para optimizar la compresión. La compresión es difícil de lograr por tu cuenta y, en ciertos casos, puede generar tiempos de respuesta más lentos con lenguaje de marcado generado de forma dinámica, que se debe comprimir sobre la marcha.
- Además, los proveedores de CDN almacenan en caché automáticamente las respuestas comprimidas para los recursos estáticos, lo que genera la mejor combinación de proporción de compresión y tiempo de respuesta.
Si bien adoptar una CDN implica una cantidad variable de esfuerzo, desde trivial hasta significativo, debería ser una prioridad alta para optimizar tu TTFB si tu sitio web aún no usa una.
Usa contenido almacenado en caché siempre que sea posible
Las CDN permiten que el contenido se almacene en caché en servidores perimetrales que se encuentran físicamente más cerca de los visitantes, siempre que el contenido esté configurado con los encabezados HTTP Cache-Control adecuados. Si bien esto no es apropiado para el contenido personalizado, requerir un viaje de regreso al origen puede anular gran parte del valor de una CDN.
En el caso de los sitios que actualizan su contenido con frecuencia, incluso un tiempo de almacenamiento en caché breve puede generar mejoras de rendimiento notables para los sitios con mucho tráfico, ya que solo el primer visitante durante ese tiempo experimenta la latencia completa de vuelta al servidor de origen, mientras que todos los demás visitantes pueden reutilizar el recurso almacenado en caché del servidor perimetral. Algunas CDN permiten la invalidación de la caché en las versiones del sitio, lo que permite lo mejor de ambos mundos: tiempos de almacenamiento en caché prolongados, pero actualizaciones instantáneas cuando es necesario.
Incluso cuando el almacenamiento en caché está configurado correctamente, esto se puede ignorar mediante el uso de parámetros de cadena de consulta únicos para la medición de estadísticas. Para la CDN, estos pueden parecer contenido diferente, aunque sean el mismo, por lo que no se usará la versión almacenada en caché.
Es posible que el contenido más antiguo o menos visitado tampoco se almacene en caché, lo que puede generar valores de TTFB más altos en algunas páginas que en otras. Aumentar los tiempos de almacenamiento en caché puede reducir el impacto de esto, pero ten en cuenta que, con tiempos de almacenamiento en caché más largos, aumenta la posibilidad de que se entregue contenido potencialmente obsoleto.
El impacto del contenido almacenado en caché no solo afecta a quienes usan CDN. Es posible que la infraestructura del servidor deba generar contenido a partir de búsquedas costosas en la base de datos cuando no se pueda reutilizar el contenido almacenado en caché. Los datos a los que se accede con más frecuencia o las páginas almacenadas en caché previa suelen tener un mejor rendimiento.
Evita que haya varios redireccionamientos de página
Un factor común que contribuye a un TTFB alto son los redireccionamientos. Los redireccionamientos se producen cuando una solicitud de navegación de un documento recibe una respuesta que informa al navegador que el recurso existe en otra ubicación. Un redireccionamiento puede agregar latencia no deseada a una solicitud de navegación, pero puede empeorar si ese redireccionamiento apunta a otro recurso que genera otro redireccionamiento, y así sucesivamente. Esto puede afectar, en particular, a los sitios que reciben grandes volúmenes de visitantes de anuncios o boletines informativos, ya que suelen redireccionar a través de servicios de estadísticas con fines de medición. Eliminar los redireccionamientos que están bajo tu control directo puede ayudar a lograr un buen TTFB.
Existen dos tipos de redireccionamientos:
- Redireccionamientos del mismo origen, en los que el redireccionamiento se produce por completo en tu sitio web.
- Redireccionamientos de origen cruzado, en los que el redireccionamiento se produce inicialmente en otro origen, como un servicio de acortamiento de URLs de redes sociales, por ejemplo, antes de llegar a tu sitio web.
Enfócate en eliminar los redireccionamientos del mismo origen, ya que tienes control directo sobre esto. Esto implicaría verificar los vínculos de tu sitio web para ver si alguno de ellos genera un código de respuesta 302 o 301. A menudo, esto puede deberse a que no se incluye el esquema https:// (por lo que los navegadores usan http:// de forma predeterminada, que luego redirecciona) o a que las barras finales no se incluyen o excluyen de forma adecuada en la URL.
Los redireccionamientos de origen cruzado son más difíciles, ya que suelen estar fuera de tu control, pero intenta evitar los redireccionamientos múltiples siempre que sea posible, por ejemplo, usando varios acortadores de vínculos cuando compartas vínculos. Asegúrate de que la URL proporcionada a los anunciantes o boletines informativos sea la URL final correcta, para no agregar otro redireccionamiento a los que usan esos servicios.
Otra fuente importante de tiempo de redireccionamiento puede provenir de los redireccionamientos de HTTP a HTTPS. Una forma de evitar esto es usar el encabezado Strict-Transport-Security (HSTS), que aplica HTTPS en la primera visita a un origen y, luego, le indica al navegador que acceda de inmediato al origen a través del esquema HTTPS en las visitas futuras.
Una vez que tengas una buena política de HSTS, puedes acelerar las cosas en la primera visita a un origen agregando tu sitio a la lista de precarga de HSTS.
Transmite lenguaje de marcado al navegador
Los navegadores están optimizados para procesar el lenguaje de marcado de manera eficiente cuando se transmite, lo que significa que el lenguaje de marcado se controla en fragmentos a medida que llega del servidor. Esto es fundamental cuando se trata de cargas útiles de lenguaje de marcado grandes, ya que significa que el navegador puede analizar los fragmentos de lenguaje de marcado de forma incremental, en lugar de esperar a que llegue toda la respuesta antes de que pueda comenzar el análisis.
Si bien los navegadores son excelentes para controlar el lenguaje de marcado de transmisión, es fundamental que hagas todo lo posible para mantener ese flujo de transmisión de modo que esos bits iniciales de lenguaje de marcado estén en camino lo antes posible. Si el backend está retrasando las cosas, eso es un problema. Debido a que las pilas de backend son numerosas, no se puede abarcar cada una de ellas ni los problemas que podrían surgir en cada una de ellas en esta guía.
React, por ejemplo, y otros frameworks que pueden renderizar lenguaje de marcado a pedido en el servidor usaron un enfoque síncrono para la renderización del servidor. Sin embargo, las versiones más recientes de React implementaron métodos de servidor para transmitir lenguaje de marcado a medida que se renderiza. Esto significa que no tienes que esperar a que un método de la API del servidor de React renderice toda la respuesta antes de enviarla.
Otra forma de garantizar que el lenguaje de marcado se transmita al navegador con rapidez es confiar en la renderización estática, que genera archivos HTML durante el tiempo de compilación. Con el archivo completo disponible de inmediato, los servidores web pueden comenzar a enviar el archivo de inmediato, y la naturaleza inherente de HTTP genera un lenguaje de marcado de transmisión. Si bien este enfoque no es adecuado para todas las páginas de todos los sitios web, como aquellas que requieren una respuesta dinámica como parte de la experiencia del usuario, puede ser beneficioso para las páginas que no requieren que el lenguaje de marcado se personalice para un usuario específico.
Usa un service worker
La API de Service Worker puede tener un gran impacto en el TTFB tanto para los documentos como para los recursos que cargan. Esto se debe a que un service worker actúa como un proxy entre el navegador y el servidor, pero el impacto en el TTFB de tu sitio web depende de cómo configures el service worker y de si esa configuración se alinea con los requisitos de tu aplicación.
- Usa una estrategia stale-while-revalidate para los recursos. Si un recurso está en la caché del service worker, ya sea un documento o un recurso que el documento requiere, la estrategia stale-while-revalidate entrega ese recurso desde la caché primero, luego descarga ese recurso en segundo plano y lo entrega desde la caché para interacciones futuras.
- Si tienes recursos de documentos que no cambian con mucha frecuencia, usar una estrategia de stale-while-revalidate puede hacer que el TTFB de una página sea casi instantáneo. Sin embargo, esto no funciona tan bien si tu sitio web envía lenguaje de marcado generado de forma dinámica, como el lenguaje de marcado que cambia según si un usuario está autenticado o no. En esos casos, siempre querrás acceder a la red primero para que el documento esté lo más actualizado posible.
- Si tu documento carga recursos no críticos que cambian con cierta frecuencia, pero recuperar el recurso inactivo no afectará en gran medida la experiencia del usuario (como imágenes seleccionadas o otros recursos que no son críticos), el TTFB de esos recursos se puede reducir en gran medida con una estrategia de stale-while-revalidate.
- Usa el modelo de shell de la app para las aplicaciones renderizadas por el cliente. Este modelo se adapta mejor a las SPA en las que el "shell" de la página se puede entregar de forma instantánea desde la caché del service worker, y el contenido dinámico de la página se propaga y renderiza más adelante en el ciclo de vida de la página.
Usa 103 Early Hints para los recursos fundamentales para la renderización
No importa qué tan bien esté optimizado el backend de tu aplicación, es posible que el servidor aún deba realizar una cantidad significativa de trabajo para preparar una respuesta, incluido el trabajo costoso (pero necesario) de la base de datos que retrasa la llegada de la respuesta de navegación lo más rápido posible. El efecto potencial de esto es que algunos recursos posteriores críticos para la renderización podrían retrasarse, como CSS o, en algunos casos, JavaScript que renderiza el lenguaje de marcado en el cliente.
El encabezado 103 Early Hints es un código de respuesta anticipada que el servidor puede enviar al navegador mientras el backend está ocupado preparando el lenguaje de marcado. Este encabezado se puede usar para indicarle al navegador que hay recursos críticos para la renderización que la página debería comenzar a descargar mientras se prepara el lenguaje de marcado. En el caso de los navegadores compatibles, el efecto puede ser una renderización de documentos (CSS) y una carga de página más rápidas.
Una desventaja de las sugerencias tempranas 103 es que, al igual que el almacenamiento en caché, pueden enmascarar el TTFB "real" de un sitio. Si la infraestructura de un servidor es lenta (ya sea porque tiene poca potencia o porque el código necesita optimización), esto puede ser menos evidente cuando se usa 103 Early Hints, ya que el TTFB parece rápido. Los sitios que usan 103 Early Hints deben considerar medir el tiempo real del servidor (a través de Server-Timing o finalResponseHeadersStart de la API de PerformanceNavigationTiming).
Conclusión
Dado que hay tantas combinaciones de pilas de aplicaciones de backend, no hay un solo artículo que pueda resumir todo lo que puedes hacer para reducir el TTFB de tu sitio web. Sin embargo, estas son algunas opciones que puedes explorar para intentar que las cosas se ejecuten un poco más rápido en el servidor.
Al igual que con la optimización de cada métrica, el enfoque es muy similar: mide tu TTFB en el campo, usa herramientas de lab para desglosar las causas y, luego, aplica optimizaciones cuando sea posible. Si bien algunas técnicas pueden no ser viables para tu situación, es probable que otras sí lo sean. Como siempre, deberás supervisar de cerca tus datos de campo y realizar los ajustes necesarios para garantizar la experiencia del usuario más rápida posible.