


Введение
Media Source Extensions (MSE) – расширение, которое позволяет управлять буферизацией и воспроизведением элементов <audio> и <video> в HTML5. Изначально они были разработаны для видеопроигрывателей, использующих адаптивную потоковую передачу данных по HTTP (DASH), но ниже мы расскажем, как их можно использовать для аудио, в частности для непрерывного воспроизведения.
Вы, вероятно, слушали музыкальный альбом, в котором песни плавно перетекали друг в друга. Возможно, вы слушаете такой прямо сейчас. Непрерывное воспроизведение – это не только художественный прием, но и особенность виниловых пластинок и компакт-дисков, на которые аудио записывалось одним непрерывным потоком. К сожалению, из-за особенностей современных аудиокодеков, таких как MP3 и AAC, это ощущение непрерывности часто теряется.
Ниже мы подробно расскажем, почему это так, а пока давайте начнем с демонстрации. Ниже приведены первые тридцать секунд отличного фильма Sintel, разбитые на пять отдельных MP3-файлов и заново собранные с помощью MSE. Красные линии указывают на пробелы, возникшие при создании (кодировании) каждого MP3-файла. В этих местах будут слышны помехи.
Фу! Это не очень удобно, и мы можем сделать лучше. Приложив немного усилий и используя те же MP3-файлы, что и в демоверсии выше, мы можем использовать MSE для удаления этих раздражающих пробелов. Зелёные линии на следующей демонстрации показывают, где файлы были соединены и пробелы удалены. В Chrome 38 и более поздних версиях воспроизведение будет плавным.
Существуют разные способы создания контента без пауз. Для целей этой демонстрации мы сосредоточимся на типе файлов, которые могут быть у обычного пользователя. Каждый файл кодируется отдельно, без учета аудиосегментов до или после него.
Базовая настройка
Сначала давайте вернемся назад и рассмотрим базовую настройку экземпляра MediaSource.
Media Source Extensions, как следует из названия, являются просто расширениями существующих медиаэлементов. Ниже мы назначаем Object URL, представляющий наш экземпляр MediaSource, атрибуту источника аудиоэлемента, как если бы мы задавали стандартный URL.
var audio = document.createElement('audio');
var mediaSource = new MediaSource();
var SEGMENTS = 5;

mediaSource.addEventListener('sourceopen', function () {
  var sourceBuffer = mediaSource.addSourceBuffer('audio/mpeg');

  function onAudioLoaded(data, index) {
    // Append the ArrayBuffer data into our new SourceBuffer.
    sourceBuffer.appendBuffer(data);
  }

  // Retrieve an audio segment via XHR.  For simplicity, we're retrieving the
  // entire segment at once, but we could also retrieve it in chunks and append
  // each chunk separately.  MSE will take care of assembling the pieces.
  GET('sintel/sintel_0.mp3', function (data) {
    onAudioLoaded(data, 0);
  });
});

audio.src = URL.createObjectURL(mediaSource);
После подключения объект MediaSource выполнит инициализацию и активирует событие sourceopen. В этот момент мы можем создать SourceBuffer. В примере выше мы создаем экземпляр audio/mpeg, который может обрабатывать и декодировать MP3-сегменты. Существуют и другие типы.
Аномальные формы сигнала
Мы вернемся к коду через минуту, а сейчас давайте подробнее рассмотрим файл, который мы только что добавили, а именно его конец. Ниже приведен график последних 3000 выборок, усредненных по обоим каналам из трека sintel_0.mp3. Каждый пиксель на красной линии – это выборка с плавающей запятой в диапазоне [-1.0, 1.0].

Что это за нулевые (тихие) сэмплы? На самом деле это артефакты сжатия, которые появляются при кодировании. Почти каждый кодировщик добавляет в файл заполнение. В этом случае LAME добавил ровно 576 пустых семплов в конец файла.
Кроме того, в начало каждого файла также было добавлено заполнение. Если мы заглянем вперед, то увидим, что в начале дорожки есть ещё 576 семплов заполнения.sintel_1.mp3 Объем заполнения зависит от кодировщика и контента, но мы знаем точные значения на основе metadata, включенных в каждый файл.
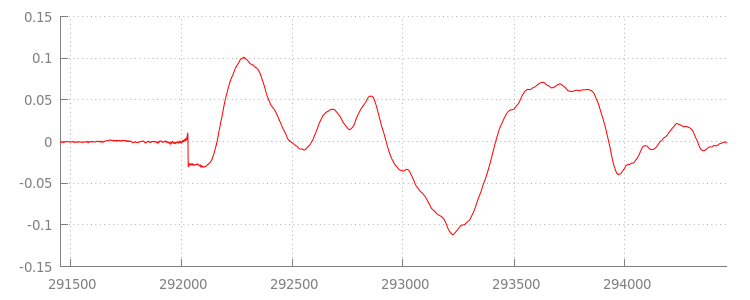
Именно из-за тишины в начале и конце каждого файла в предыдущей демонстрации между сегментами возникали сбои. Чтобы добиться непрерывного воспроизведения,
нам нужно удалить эти участки тишины. К счастью, это легко сделать с помощью MediaSource. Ниже мы изменим метод onAudioLoaded(), чтобы использовать окно добавления и смещение временной метки для удаления тишины.
Пример кода
function onAudioLoaded(data, index) {
  // Parsing gapless metadata is unfortunately non trivial and a bit messy, so
  // we'll glaze over it here; see the appendix for details.
  // ParseGaplessData() will return a dictionary with two elements:
  //
  //    audioDuration: Duration in seconds of all non-padding audio.
  //    frontPaddingDuration: Duration in seconds of the front padding.
  //
  var gaplessMetadata = ParseGaplessData(data);

  // Each appended segment must be appended relative to the next.  To avoid any
  // overlaps, we'll use the end timestamp of the last append as the starting
  // point for our next append or zero if we haven't appended anything yet.
  var appendTime = index > 0 ? sourceBuffer.buffered.end(0) : 0;

  // Simply put, an append window allows you to trim off audio (or video) frames
  // which fall outside of a specified time range.  Here, we'll use the end of
  // our last append as the start of our append window and the end of the real
  // audio data for this segment as the end of our append window.
  sourceBuffer.appendWindowStart = appendTime;
  sourceBuffer.appendWindowEnd = appendTime + gaplessMetadata.audioDuration;

  // The timestampOffset field essentially tells MediaSource where in the media
  // timeline the data given to appendBuffer() should be placed.  I.e., if the
  // timestampOffset is 1 second, the appended data will start 1 second into
  // playback.
  //
  // MediaSource requires that the media timeline starts from time zero, so we
  // need to ensure that the data left after filtering by the append window
  // starts at time zero.  We'll do this by shifting all of the padding we want
  // to discard before our append time (and thus, before our append window).
  sourceBuffer.timestampOffset =
    appendTime - gaplessMetadata.frontPaddingDuration;

  // When appendBuffer() completes, it will fire an updateend event signaling
  // that it's okay to append another segment of media.  Here, we'll chain the
  // append for the next segment to the completion of our current append.
  if (index == 0) {
    sourceBuffer.addEventListener('updateend', function () {
      if (++index < SEGMENTS) {
        GET('sintel/sintel_' + index + '.mp3', function (data) {
          onAudioLoaded(data, index);
        });
      } else {
        // We've loaded all available segments, so tell MediaSource there are no
        // more buffers which will be appended.
        mediaSource.endOfStream();
        URL.revokeObjectURL(audio.src);
      }
    });
  }

  // appendBuffer() will now use the timestamp offset and append window settings
  // to filter and timestamp the data we're appending.
  //
  // Note: While this demo uses very little memory, more complex use cases need
  // to be careful about memory usage or garbage collection may remove ranges of
  // media in unexpected places.
  sourceBuffer.appendBuffer(data);
}
Непрерывная временная диаграмма сигнала
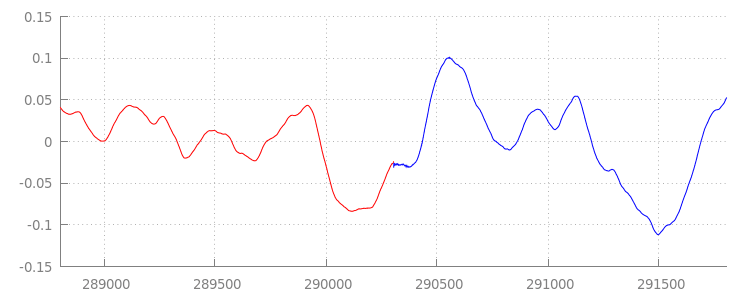
Давайте посмотрим, чего мы добились с помощью нашего нового кода, и ещё раз взглянем на форму сигнала после применения окон добавления. Ниже вы можете увидеть, что тихий раздел в конце sintel_0.mp3 (красный) и тихий раздел в начале sintel_1.mp3 (синий) были удалены, что позволило нам плавно перейти между сегментами.
Заключение
На этом мы завершаем демонстрацию. Прежде чем мы закончим, вы могли заметить, что наш метод onAudioLoaded() не учитывает контейнеры или кодеки.
Это означает, что все эти методы будут работать независимо от типа контейнера или кодека. Ниже вы можете воспроизвести исходный демо-файл MP4, фрагментированный для DASH, вместо MP3.
Если вы хотите узнать больше, ознакомьтесь с приложениями ниже, в которых подробно рассматривается создание контента без пауз и синтаксический анализ метаданных. Вы также можете изучить gapless.js, чтобы лучше понять, как работает код в этой демонстрации.
Благодарим за внимание!
Приложение А. Создание контента без пауз
Создать контент без пауз может быть непросто. Ниже мы рассмотрим создание медиафайла Sintel, используемого в этой демонстрации. Для начала вам понадобится копия саундтрека к фильму Sintel в формате FLAC без потерь. Для справки ниже приведен хеш SHA1. Вам понадобятся инструменты FFmpeg, MP4Box, LAME и afconvert (входит в состав macOS).
    unzip Jan_Morgenstern-Sintel-FLAC.zip
    sha1sum 1-Snow_Fight.flac
    # 0535ca207ccba70d538f7324916a3f1a3d550194  1-Snow_Fight.flac
Сначала мы вырежем первые 31, 5 секунды трека 1-Snow_Fight.flac. Мы также хотим добавить затухание на 2,5 секунды, начиная с 28-й секунды, чтобы избежать щелчков после окончания воспроизведения. С помощью приведенной ниже команды FFmpeg мы можем выполнить все эти действия и поместить результаты в sintel.flac.
ffmpeg -i 1-Snow_Fight.flac -t 31.5 -af "afade=t=out:st=28:d=2.5" sintel.flac
Затем мы разделим файл на пять файлов wave по 6,5 секунды каждый.Формат wave удобен тем, что его поддерживает практически любой кодировщик. Снова воспользуемся FFmpeg. Получим следующие файлы: sintel_0.wav, sintel_1.wav, sintel_2.wav, sintel_3.wav и sintel_4.wav.
    ffmpeg -i sintel.flac -acodec pcm_f32le -map 0 -f segment \
           -segment_list out.list -segment_time 6.5 sintel_%d.wav
Теперь создадим MP3-файлы. В LAME есть несколько вариантов создания контента без пауз. Если вы управляете контентом, то можете использовать --nogap с пакетным кодированием всех файлов, чтобы избежать заполнения между сегментами.
Однако в рамках этой демонстрации мы хотим использовать заполнение, поэтому применим стандартное кодирование VBR высокого качества для файлов WAV.
    lame -V=2 sintel_0.wav sintel_0.mp3
    lame -V=2 sintel_1.wav sintel_1.mp3
    lame -V=2 sintel_2.wav sintel_2.mp3
    lame -V=2 sintel_3.wav sintel_3.mp3
    lame -V=2 sintel_4.wav sintel_4.mp3
Это все, что нужно для создания MP3-файлов. Теперь давайте рассмотрим создание фрагментированных файлов MP4. Мы будем следовать инструкциям Apple по созданию медиафайлов, оптимизированных для iTunes. Ниже мы преобразуем файлы WAV в промежуточные файлы CAF в соответствии с инструкциями, а затем закодируем их в формате AAC в контейнере MP4, используя рекомендуемые параметры.
    afconvert sintel_0.wav sintel_0_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_1.wav sintel_1_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_2.wav sintel_2_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_3.wav sintel_3_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_4.wav sintel_4_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_0_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_0.m4a
    afconvert sintel_1_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_1.m4a
    afconvert sintel_2_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_2.m4a
    afconvert sintel_3_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_3.m4a
    afconvert sintel_4_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_4.m4a
Теперь у нас есть несколько файлов M4A, которые нужно правильно фрагментировать, прежде чем использовать с MediaSource. В нашем примере размер фрагмента будет равен одной секунде. MP4Box запишет каждый фрагментированный файл MP4 как sintel_#_dashinit.mp4 вместе с манифестом MPEG-DASH (sintel_#_dash.mpd), который можно удалить.
    MP4Box -dash 1000 sintel_0.m4a && mv sintel_0_dashinit.mp4 sintel_0.mp4
    MP4Box -dash 1000 sintel_1.m4a && mv sintel_1_dashinit.mp4 sintel_1.mp4
    MP4Box -dash 1000 sintel_2.m4a && mv sintel_2_dashinit.mp4 sintel_2.mp4
    MP4Box -dash 1000 sintel_3.m4a && mv sintel_3_dashinit.mp4 sintel_3.mp4
    MP4Box -dash 1000 sintel_4.m4a && mv sintel_4_dashinit.mp4 sintel_4.mp4
    rm sintel_{0,1,2,3,4}_dash.mpd
Готово! Теперь у нас есть фрагментированные файлы MP4 и MP3 с правильными метаданными, необходимыми для непрерывного воспроизведения. Подробную информацию о том, как выглядят эти метаданные, можно найти в приложении Б.
Приложение Б. Анализ метаданных для непрерывного воспроизведения
Как и в случае с созданием контента без пауз, обработка метаданных может быть сложной, поскольку стандартного метода хранения не существует. Ниже мы расскажем, как два самых распространенных кодировщика, LAME и iTunes, хранят метаданные для непрерывного воспроизведения. Для начала настроим вспомогательные методы и структуру для ParseGaplessData(), который мы использовали выше.
    // Since most MP3 encoders store the gapless metadata in binary, we'll need a
    // method for turning bytes into integers.  Note: This doesn't work for values
    // larger than 2^30 since we'll overflow the signed integer type when shifting.
    function ReadInt(buffer) {
      var result = buffer.charCodeAt(0);
      for (var i = 1; i < buffer.length; ++i) {
        result <<= 8;
        result += buffer.charCodeAt(i);
      }
      return result;
    }

    function ParseGaplessData(arrayBuffer) {
      // Gapless data is generally within the first 512 bytes, so limit parsing.
      var byteStr = new TextDecoder().decode(arrayBuffer.slice(0, 512));

      var frontPadding = 0, endPadding = 0, realSamples = 0;

      // ... we'll fill this in as we go below.
Сначала мы рассмотрим формат метаданных Apple iTunes, поскольку его проще всего анализировать и объяснять. В файлах MP3 и M4A iTunes (и afconvert) записывают короткий раздел в ASCII, например:
iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00
Она записывается в тег ID3 в контейнере MP3 и в атом метаданных в контейнере MP4. Первый токен 0000000 можно проигнорировать. Следующие три токена – это заполнение в начале, заполнение в конце и общее количество семплов без заполнения. Разделив каждое из этих значений на частоту дискретизации аудио, мы получим продолжительность каждого из них.
// iTunes encodes the gapless data as hex strings like so:
//
//    'iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00'
//    'iTunSMPB[ 26 bytes ]####### frontpad  endpad    real samples'
//
// The approach here elides the complexity of actually parsing MP4 atoms. It
// may not work for all files without some tweaks.
var iTunesDataIndex = byteStr.indexOf('iTunSMPB');
if (iTunesDataIndex != -1) {
  var frontPaddingIndex = iTunesDataIndex + 34;
  frontPadding = parseInt(byteStr.substr(frontPaddingIndex, 8), 16);

  var endPaddingIndex = frontPaddingIndex + 9;
  endPadding = parseInt(byteStr.substr(endPaddingIndex, 8), 16);

  var sampleCountIndex = endPaddingIndex + 9;
  realSamples = parseInt(byteStr.substr(sampleCountIndex, 16), 16);
}
С другой стороны, большинство кодировщиков MP3 с открытым исходным кодом хранят метаданные для непрерывного воспроизведения в специальном заголовке Xing, который помещается в пустой фрейм MPEG. Он пустой, чтобы декодеры, которые не распознают заголовок Xing, просто воспроизводили тишину. К сожалению, этот тег не всегда присутствует и имеет ряд необязательных полей. В этой демонстрации мы управляем медиафайлами, но на практике потребуются дополнительные проверки, чтобы узнать, когда метаданные для непрерывного воспроизведения действительно доступны.
Сначала мы проанализируем общее количество выборок. Для простоты мы будем считывать его из заголовка Xing, но его можно получить и из обычного заголовка MPEG Audio.
Заголовки Xing могут быть помечены тегом Xing или Info. Ровно 4 байта. После этого тега идут 32 бита, которые представляют общее количество кадров в файле. Если умножить это значение на количество выборок в кадре, получится общее количество выборок в файле.
    // Xing padding is encoded as 24bits within the header.  Note: This code will
    // only work for Layer3 Version 1 and Layer2 MP3 files with XING frame counts
    // and gapless information.  See the following document for more details:
    // http://www.codeproject.com/Articles/8295/MPEG-Audio-Frame-Header
    var xingDataIndex = byteStr.indexOf('Xing');
    if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Info');
    if (xingDataIndex != -1) {
      // See section 2.3.1 in the link above for the specifics on parsing the Xing
      // frame count.
      var frameCountIndex = xingDataIndex + 8;
      var frameCount = ReadInt(byteStr.substr(frameCountIndex, 4));

      // For Layer3 Version 1 and Layer2 there are 1152 samples per frame.  See
      // section 2.1.5 in the link above for more details.
      var paddedSamples = frameCount * 1152;

      // ... we'll cover this below.
Теперь, когда у нас есть общее количество семплов, мы можем перейти к считыванию количества семплов заполнения. В зависимости от кодировщика эта информация может быть записана в теге LAME или Lavf, вложенном в заголовок Xing. Ровно через 17 байт после этого заголовка находятся 3 байта, представляющие отступы в начале и конце (по 12 бит каждый).
        xingDataIndex = byteStr.indexOf('LAME');
        if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Lavf');
        if (xingDataIndex != -1) {
          // See http://gabriel.mp3-tech.org/mp3infotag.html#delays for details of
          // how this information is encoded and parsed.
          var gaplessDataIndex = xingDataIndex + 21;
          var gaplessBits = ReadInt(byteStr.substr(gaplessDataIndex, 3));

          // Upper 12 bits are the front padding, lower are the end padding.
          frontPadding = gaplessBits >> 12;
          endPadding = gaplessBits & 0xFFF;
        }

        realSamples = paddedSamples - (frontPadding + endPadding);
      }

      return {
        audioDuration: realSamples * SECONDS_PER_SAMPLE,
        frontPaddingDuration: frontPadding * SECONDS_PER_SAMPLE
      };
    }
Теперь у нас есть полная функция для синтаксического анализа подавляющего большинства контента без пауз. Однако в некоторых случаях могут возникать проблемы, поэтому будьте осторожны при использовании подобного кода в рабочей среде.
Приложение C. Сборка мусора
Память, принадлежащая экземплярам SourceBuffer, активно очищается в соответствии с типом контента, ограничениями платформы и текущей позицией воспроизведения. В Chrome память сначала будет освобождаться из уже воспроизведенных буферов.
Однако если использование памяти превышает ограничения платформы, то память будет освобождаться за счет невоспроизведенных буферов.
Когда воспроизведение доходит до пробела в хронологии, вызванного освобождением памяти, могут возникнуть сбои, если пробел небольшой, или воспроизведение может полностью остановиться, если пробел слишком велик. Ни то, ни другое не является хорошим пользовательским опытом, поэтому важно избегать добавления слишком большого количества данных за один раз и вручную удалять диапазоны из временной шкалы мультимедиа, которые больше не нужны.
Диапазоны можно удалить с помощью метода remove() для каждого объекта SourceBuffer. Этот метод принимает диапазон [start, end] в секундах.
Как и в случае с appendBuffer(), каждый remove() будет активировать событие updateend после завершения. Другие операции удаления или добавления не должны выполняться до активации события.
В Chrome для компьютеров можно одновременно хранить в памяти около 12 МБ аудиоконтента и 150 МБ видеоконтента. Не следует полагаться на эти значения в разных браузерах или на разных платформах. Например, они не являются репрезентативными для мобильных устройств.
Сборка мусора влияет только на данные, добавленные в SourceBuffers. Ограничений на объем данных, которые можно хранить в буфере в переменных JavaScript, нет. При необходимости вы можете повторно добавить те же данные в ту же позицию.