


Introduzione
Le Media Source Extensions (MSE)
forniscono un controllo esteso del buffering e dei controlli di riproduzione per gli elementi HTML5 <audio> e
<video>. Sebbene siano stati originariamente sviluppati per facilitare i video player basati su Dynamic Adaptive Streaming over HTTP (DASH), di seguito vedremo come possono essere utilizzati per l'audio, in particolare per la riproduzione continua.
Probabilmente hai ascoltato un album musicale in cui i brani si susseguivano senza interruzioni, o forse ne stai ascoltando uno proprio ora. Gli artisti creano queste esperienze di riproduzione continua sia come scelta artistica sia come artefatto dei dischi in vinile e dei CD, in cui l'audio veniva scritto come un unico stream continuo. Purtroppo, a causa del modo in cui funzionano i moderni codec audio come MP3 e AAC, questa esperienza uditiva senza interruzioni oggi viene spesso persa.
Più avanti entreremo nei dettagli, ma per ora iniziamo con una dimostrazione. Di seguito sono riportati i primi trenta secondi dell'eccellente Sintel suddivisi in cinque file MP3 separati e riassemblati utilizzando MSE. Le linee rosse indicano le pause introdotte durante la creazione (codifica) di ogni MP3; in questi punti sentirai dei problemi.
Che schifo! Non è un'esperienza ottimale, possiamo fare di meglio. Con un po' di lavoro in più, utilizzando esattamente gli stessi file MP3 della demo precedente, possiamo utilizzare MSE per rimuovere queste fastidiose interruzioni. Le linee verdi nella demo successiva indicano i punti in cui i file sono stati uniti e gli spazi vuoti rimossi. Su Chrome 38 e versioni successive, la riproduzione sarà perfetta.
Esistono diversi modi per creare contenuti senza interruzioni. Ai fini di questa demo, ci concentreremo sul tipo di file che un utente normale potrebbe avere a disposizione. In questo caso, ogni file è stato codificato separatamente senza tenere conto dei segmenti audio precedenti o successivi.
Configurazione di base
Innanzitutto, facciamo un passo indietro e vediamo la configurazione di base di un'istanza MediaSource.
Le Media Source Extensions, come suggerisce il nome, sono solo estensioni degli elementi multimediali esistenti. Di seguito, assegniamo un
Object URL,
che rappresenta la nostra istanza MediaSource, all'attributo source di un elemento audio, proprio come faresti per impostare un URL standard.
var audio = document.createElement('audio');
var mediaSource = new MediaSource();
var SEGMENTS = 5;

mediaSource.addEventListener('sourceopen', function () {
  var sourceBuffer = mediaSource.addSourceBuffer('audio/mpeg');

  function onAudioLoaded(data, index) {
    // Append the ArrayBuffer data into our new SourceBuffer.
    sourceBuffer.appendBuffer(data);
  }

  // Retrieve an audio segment via XHR.  For simplicity, we're retrieving the
  // entire segment at once, but we could also retrieve it in chunks and append
  // each chunk separately.  MSE will take care of assembling the pieces.
  GET('sintel/sintel_0.mp3', function (data) {
    onAudioLoaded(data, 0);
  });
});

audio.src = URL.createObjectURL(mediaSource);
Una volta connesso l'oggetto MediaSource, eseguirà alcune inizializzazioni e infine attiverà un evento sourceopen; a quel punto possiamo creare un SourceBuffer. Nell'esempio precedente, creiamo un audio/mpeg, in grado di analizzare e decodificare i nostri segmenti MP3. Sono disponibili diversi altri tipi.
Forme d'onda anomale
Torneremo al codice tra un attimo, ma ora diamo un'occhiata più da vicino al file che abbiamo appena aggiunto, in particolare alla fine. Di seguito è riportato un grafico degli ultimi 3000 campioni calcolati come media su entrambi i canali della traccia sintel_0.mp3. Ogni pixel sulla linea rossa è un
campione in virgola mobile
nell'intervallo di [-1.0, 1.0].

Cosa sono tutti questi campioni zero (silenziosi)? In realtà sono dovuti ad artefatti di compressione introdotti durante la codifica. Quasi tutti i codificatori introducono un qualche tipo di padding. In questo caso, LAME ha aggiunto esattamente 576 sample di spaziatura interna alla fine del file.
Oltre al padding alla fine, a ogni file è stato aggiunto anche un padding all'inizio. Se diamo un'occhiata alla traccia sintel_1.mp3, vedremo che all'inizio sono presenti altri 576 sample di spaziatura interna. La quantità di padding varia in base al codificatore e ai contenuti, ma conosciamo i valori esatti in base ai metadata inclusi in ogni file.
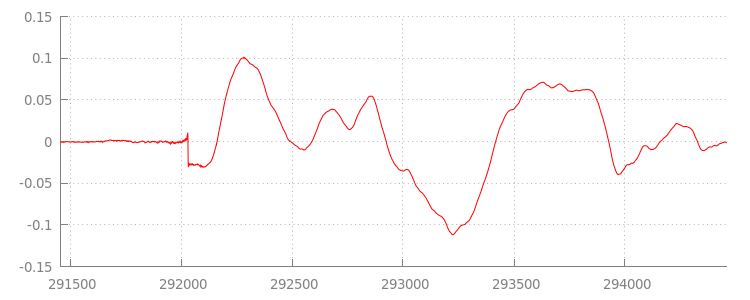
Le sezioni di silenzio all'inizio e alla fine di ogni file sono la causa dei glitch tra i segmenti nella demo precedente. Per ottenere una riproduzione senza pause, dobbiamo rimuovere queste sezioni di silenzio. Per fortuna, questo è facile da fare con
MediaSource. Di seguito, modificheremo il nostro metodo onAudioLoaded() per utilizzare una finestra di aggiunta e un offset del timestamp per rimuovere questo silenzio.
Esempio di codice
function onAudioLoaded(data, index) {
  // Parsing gapless metadata is unfortunately non trivial and a bit messy, so
  // we'll glaze over it here; see the appendix for details.
  // ParseGaplessData() will return a dictionary with two elements:
  //
  //    audioDuration: Duration in seconds of all non-padding audio.
  //    frontPaddingDuration: Duration in seconds of the front padding.
  //
  var gaplessMetadata = ParseGaplessData(data);

  // Each appended segment must be appended relative to the next.  To avoid any
  // overlaps, we'll use the end timestamp of the last append as the starting
  // point for our next append or zero if we haven't appended anything yet.
  var appendTime = index > 0 ? sourceBuffer.buffered.end(0) : 0;

  // Simply put, an append window allows you to trim off audio (or video) frames
  // which fall outside of a specified time range.  Here, we'll use the end of
  // our last append as the start of our append window and the end of the real
  // audio data for this segment as the end of our append window.
  sourceBuffer.appendWindowStart = appendTime;
  sourceBuffer.appendWindowEnd = appendTime + gaplessMetadata.audioDuration;

  // The timestampOffset field essentially tells MediaSource where in the media
  // timeline the data given to appendBuffer() should be placed.  I.e., if the
  // timestampOffset is 1 second, the appended data will start 1 second into
  // playback.
  //
  // MediaSource requires that the media timeline starts from time zero, so we
  // need to ensure that the data left after filtering by the append window
  // starts at time zero.  We'll do this by shifting all of the padding we want
  // to discard before our append time (and thus, before our append window).
  sourceBuffer.timestampOffset =
    appendTime - gaplessMetadata.frontPaddingDuration;

  // When appendBuffer() completes, it will fire an updateend event signaling
  // that it's okay to append another segment of media.  Here, we'll chain the
  // append for the next segment to the completion of our current append.
  if (index == 0) {
    sourceBuffer.addEventListener('updateend', function () {
      if (++index < SEGMENTS) {
        GET('sintel/sintel_' + index + '.mp3', function (data) {
          onAudioLoaded(data, index);
        });
      } else {
        // We've loaded all available segments, so tell MediaSource there are no
        // more buffers which will be appended.
        mediaSource.endOfStream();
        URL.revokeObjectURL(audio.src);
      }
    });
  }

  // appendBuffer() will now use the timestamp offset and append window settings
  // to filter and timestamp the data we're appending.
  //
  // Note: While this demo uses very little memory, more complex use cases need
  // to be careful about memory usage or garbage collection may remove ranges of
  // media in unexpected places.
  sourceBuffer.appendBuffer(data);
}
Una forma d'onda continua
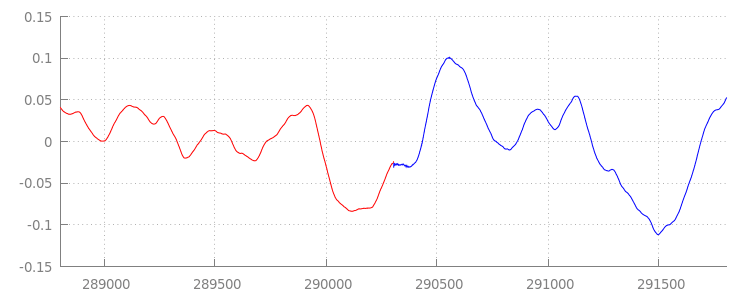
Vediamo cosa ha ottenuto il nostro nuovo codice dando un'altra occhiata alla forma d'onda dopo aver applicato le finestre di aggiunta. Di seguito, puoi vedere che la sezione silenziosa alla fine di sintel_0.mp3 (in rosso) e la sezione silenziosa all'inizio di sintel_1.mp3 (in blu) sono state rimosse, lasciando una transizione fluida tra i segmenti.
Conclusione
Con questo, abbiamo unito tutti e cinque i segmenti in uno solo e abbiamo raggiunto la fine della nostra demo. Prima di concludere, avrai notato che il nostro metodo onAudioLoaded() non tiene conto di container o codec.
Ciò significa che tutte queste tecniche funzioneranno indipendentemente dal tipo di container o codec. Di seguito puoi riprodurre di nuovo la demo originale con un file MP4 frammentato pronto per DASH anziché un file MP3.
Per saperne di più, consulta le appendici di seguito per un'analisi più approfondita della creazione di contenuti senza interruzioni e dell'analisi dei metadati. Puoi anche esplorare gapless.js per esaminare più da vicino il codice che alimenta questa demo.
Grazie per l'attenzione.
Appendice A: creazione di contenuti senza interruzioni
Creare contenuti senza interruzioni può essere difficile. Di seguito illustreremo la creazione dei contenuti multimediali di Sintel utilizzati in questa demo. Per iniziare, avrai bisogno di una copia della colonna sonora FLAC lossless di Sintel. Per i posteri, lo SHA1 è incluso di seguito. Per gli strumenti, avrai bisogno di FFmpeg, MP4Box, LAME e un'installazione di OSX con afconvert.
    unzip Jan_Morgenstern-Sintel-FLAC.zip
    sha1sum 1-Snow_Fight.flac
    # 0535ca207ccba70d538f7324916a3f1a3d550194  1-Snow_Fight.flac
Innanzitutto, divideremo i primi 31,5 secondi della traccia 1-Snow_Fight.flac. Vogliamo anche aggiungere una dissolvenza in uscita di 2,5 secondi a partire da 28 secondi per evitare eventuali clic al termine della riproduzione. Utilizzando la riga di comando FFmpeg riportata di seguito, possiamo eseguire tutte queste operazioni e inserire i risultati in sintel.flac.
ffmpeg -i 1-Snow_Fight.flac -t 31.5 -af "afade=t=out:st=28:d=2.5" sintel.flac
Successivamente, suddivideremo il file in 5 file wave di 6,5 secondi ciascuno.È più facile utilizzare il formato wave poiché quasi tutti i codificatori ne supportano l'importazione. Anche in questo caso, possiamo farlo con precisione con FFmpeg, dopodiché avremo: sintel_0.wav, sintel_1.wav, sintel_2.wav, sintel_3.wav e sintel_4.wav.
    ffmpeg -i sintel.flac -acodec pcm_f32le -map 0 -f segment \
           -segment_list out.list -segment_time 6.5 sintel_%d.wav
Ora creiamo i file MP3. LAME offre diverse opzioni per la creazione di contenuti senza pause. Se hai il controllo dei contenuti, potresti prendere in considerazione l'utilizzo di --nogap con una codifica batch di tutti i file per evitare del tutto il padding tra i segmenti.
Tuttavia, ai fini di questa demo, vogliamo questo padding, quindi utilizzeremo una codifica VBR standard di alta qualità dei file wave.
    lame -V=2 sintel_0.wav sintel_0.mp3
    lame -V=2 sintel_1.wav sintel_1.mp3
    lame -V=2 sintel_2.wav sintel_2.mp3
    lame -V=2 sintel_3.wav sintel_3.mp3
    lame -V=2 sintel_4.wav sintel_4.mp3
Questo è tutto ciò che serve per creare i file MP3. Ora vediamo la creazione dei file MP4 frammentati. Seguiremo le istruzioni di Apple per la creazione di contenuti multimediali masterizzati per iTunes. Di seguito, convertiremo i file wave in file CAF intermedi, come indicato nelle istruzioni, prima di codificarli come AAC in un container MP4 utilizzando i parametri consigliati.
    afconvert sintel_0.wav sintel_0_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_1.wav sintel_1_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_2.wav sintel_2_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_3.wav sintel_3_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_4.wav sintel_4_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_0_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_0.m4a
    afconvert sintel_1_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_1.m4a
    afconvert sintel_2_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_2.m4a
    afconvert sintel_3_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_3.m4a
    afconvert sintel_4_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_4.m4a
Ora abbiamo diversi file M4A che dobbiamo
frammentare
in modo appropriato prima di poterli utilizzare con
MediaSource. Per i nostri scopi, utilizzeremo una dimensione del frammento di un secondo. MP4Box scriverà ogni MP4 frammentato come sintel_#_dashinit.mp4 insieme a un manifest MPEG-DASH (sintel_#_dash.mpd) che può essere ignorato.
    MP4Box -dash 1000 sintel_0.m4a && mv sintel_0_dashinit.mp4 sintel_0.mp4
    MP4Box -dash 1000 sintel_1.m4a && mv sintel_1_dashinit.mp4 sintel_1.mp4
    MP4Box -dash 1000 sintel_2.m4a && mv sintel_2_dashinit.mp4 sintel_2.mp4
    MP4Box -dash 1000 sintel_3.m4a && mv sintel_3_dashinit.mp4 sintel_3.mp4
    MP4Box -dash 1000 sintel_4.m4a && mv sintel_4_dashinit.mp4 sintel_4.mp4
    rm sintel_{0,1,2,3,4}_dash.mpd
È tutto. Ora abbiamo file MP4 e MP3 frammentati con i metadati corretti necessari per la riproduzione senza interruzioni. Per ulteriori dettagli sull'aspetto di questi metadati, consulta l'Appendice B.
Appendice B: analisi dei metadati gapless
Proprio come la creazione di contenuti senza pause, l'analisi dei metadati senza pause può essere complicata,
poiché non esiste un metodo standard per l'archiviazione. Di seguito spiegheremo come i due codificatori più comuni, LAME e iTunes, memorizzano i metadati gapless. Iniziamo configurando alcuni metodi helper e una struttura per l'oggetto ParseGaplessData() utilizzato sopra.
    // Since most MP3 encoders store the gapless metadata in binary, we'll need a
    // method for turning bytes into integers.  Note: This doesn't work for values
    // larger than 2^30 since we'll overflow the signed integer type when shifting.
    function ReadInt(buffer) {
      var result = buffer.charCodeAt(0);
      for (var i = 1; i < buffer.length; ++i) {
        result <<= 8;
        result += buffer.charCodeAt(i);
      }
      return result;
    }

    function ParseGaplessData(arrayBuffer) {
      // Gapless data is generally within the first 512 bytes, so limit parsing.
      var byteStr = new TextDecoder().decode(arrayBuffer.slice(0, 512));

      var frontPadding = 0, endPadding = 0, realSamples = 0;

      // ... we'll fill this in as we go below.
Inizieremo con il formato dei metadati di iTunes di Apple, poiché è il più semplice da analizzare e spiegare. All'interno dei file MP3 e M4A, iTunes (e afconvert) scrive una breve sezione in ASCII, come segue:
iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00
Questi dati vengono scritti all'interno di un tag ID3 nel container MP3 e di un atomo di metadati nel container MP4. Per i nostri scopi, possiamo ignorare il primo token 0000000. I tre token successivi sono il padding iniziale, il padding finale e il numero totale di campioni senza padding. Dividendo ciascuno di questi valori per la frequenza di campionamento dell'audio, otteniamo la durata di ciascuno.
// iTunes encodes the gapless data as hex strings like so:
//
//    'iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00'
//    'iTunSMPB[ 26 bytes ]####### frontpad  endpad    real samples'
//
// The approach here elides the complexity of actually parsing MP4 atoms. It
// may not work for all files without some tweaks.
var iTunesDataIndex = byteStr.indexOf('iTunSMPB');
if (iTunesDataIndex != -1) {
  var frontPaddingIndex = iTunesDataIndex + 34;
  frontPadding = parseInt(byteStr.substr(frontPaddingIndex, 8), 16);

  var endPaddingIndex = frontPaddingIndex + 9;
  endPadding = parseInt(byteStr.substr(endPaddingIndex, 8), 16);

  var sampleCountIndex = endPaddingIndex + 9;
  realSamples = parseInt(byteStr.substr(sampleCountIndex, 16), 16);
}
D'altra parte, la maggior parte degli encoder MP3 open source memorizza i metadati gapless all'interno di un'apposita intestazione Xing inserita in un frame MPEG silenzioso (è silenzioso in modo che i decoder che non comprendono l'intestazione Xing riproducano semplicemente il silenzio). Purtroppo questo tag non è sempre presente e ha una serie di campi facoltativi. Ai fini di questa demo, abbiamo il controllo sui contenuti multimediali, ma in pratica saranno necessari alcuni controlli di sensibilità aggiuntivi per sapere quando i metadati senza pause sono effettivamente disponibili.
Innanzitutto, analizzeremo il numero totale di campioni. Per semplicità, leggeremo questo valore dall'intestazione Xing, ma potrebbe essere costruito dalla normale intestazione audio MPEG.
Le intestazioni Xing possono essere contrassegnate da un tag Xing o Info. Esattamente 4 byte dopo questo tag sono presenti 32 bit che rappresentano il numero totale di frame nel file. Moltiplicando questo valore per il numero di campioni per frame, otterremo i campioni totali nel file.
    // Xing padding is encoded as 24bits within the header.  Note: This code will
    // only work for Layer3 Version 1 and Layer2 MP3 files with XING frame counts
    // and gapless information.  See the following document for more details:
    // http://www.codeproject.com/Articles/8295/MPEG-Audio-Frame-Header
    var xingDataIndex = byteStr.indexOf('Xing');
    if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Info');
    if (xingDataIndex != -1) {
      // See section 2.3.1 in the link above for the specifics on parsing the Xing
      // frame count.
      var frameCountIndex = xingDataIndex + 8;
      var frameCount = ReadInt(byteStr.substr(frameCountIndex, 4));

      // For Layer3 Version 1 and Layer2 there are 1152 samples per frame.  See
      // section 2.1.5 in the link above for more details.
      var paddedSamples = frameCount * 1152;

      // ... we'll cover this below.
Ora che abbiamo il numero totale di campioni, possiamo passare alla lettura del numero di campioni di spaziatura interna. A seconda del codificatore, queste informazioni potrebbero essere scritte in un tag LAME o Lavf nidificato nell'intestazione Xing. Esattamente 17 byte dopo questa intestazione, sono presenti 3 byte che rappresentano il padding iniziale e finale, ciascuno di 12 bit.
        xingDataIndex = byteStr.indexOf('LAME');
        if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Lavf');
        if (xingDataIndex != -1) {
          // See http://gabriel.mp3-tech.org/mp3infotag.html#delays for details of
          // how this information is encoded and parsed.
          var gaplessDataIndex = xingDataIndex + 21;
          var gaplessBits = ReadInt(byteStr.substr(gaplessDataIndex, 3));

          // Upper 12 bits are the front padding, lower are the end padding.
          frontPadding = gaplessBits >> 12;
          endPadding = gaplessBits & 0xFFF;
        }

        realSamples = paddedSamples - (frontPadding + endPadding);
      }

      return {
        audioDuration: realSamples * SECONDS_PER_SAMPLE,
        frontPaddingDuration: frontPadding * SECONDS_PER_SAMPLE
      };
    }
In questo modo, abbiamo una funzione completa per analizzare la maggior parte dei contenuti senza pause. Tuttavia, i casi limite sono sicuramente numerosi, quindi è consigliabile prestare attenzione prima di utilizzare un codice simile in produzione.
Appendice C: sulla garbage collection
La memoria appartenente alle istanze SourceBuffer viene attivamente sottoposta a garbage collection in base al tipo di contenuti, ai limiti specifici della piattaforma e alla posizione di riproduzione corrente. In Chrome, la memoria verrà prima recuperata dai buffer già riprodotti.
Tuttavia, se la memoria utilizzata supera i limiti specifici della piattaforma, rimuoverà la memoria dai buffer non riprodotti.
Quando la riproduzione raggiunge un intervallo nella cronologia a causa della memoria recuperata, potrebbe presentare problemi se l'intervallo è abbastanza piccolo o bloccarsi completamente se l'intervallo è troppo grande. Nessuna delle due è un'esperienza utente ottimale, quindi è importante evitare di aggiungere troppi dati contemporaneamente e rimuovere manualmente dalla sequenza temporale dei contenuti multimediali gli intervalli che non sono più necessari.
Gli intervalli possono essere rimossi tramite il metodo remove() su ogni SourceBuffer, che accetta un intervallo [start, end] in secondi.
Analogamente a appendBuffer(), ogni remove() attiverà un evento updateend una volta completato. Non devono essere eseguite altre rimozioni o aggiunte finché l'evento non viene attivato.
Su Chrome per computer, puoi conservare in memoria circa 12 megabyte di contenuti audio e 150 megabyte di contenuti video alla volta. Non devi fare affidamento su questi valori per tutti i browser o le piattaforme; ad esempio, non sono sicuramente rappresentativi dei dispositivi mobili.
La garbage collection influisce solo sui dati aggiunti a SourceBuffers; non esistono limiti alla quantità di dati che puoi conservare nel buffer nelle variabili JavaScript. Se necessario, puoi anche aggiungere nuovamente gli stessi dati nella stessa posizione.