


מבוא
Media Source Extensions (MSE) מספקות שליטה מורחבת על אגירת נתונים והפעלה של רכיבי <audio> ו-<video> ב-HTML5. במקור, הן פותחו כדי לאפשר נגני וידאו שמבוססים על שידור דינמי שניתן להתאמה באמצעות HTTP (DASH), אבל בהמשך נראה איך אפשר להשתמש בהן לאודיו, ובמיוחד להפעלה ללא הפסקות.
סביר להניח שהאזנתם לאלבום מוזיקה שבו השירים זרמו בצורה חלקה בין הטראקים. יכול להיות שאתם מאזינים לאלבום כזה ממש עכשיו. אומנים יוצרים את חוויות ההשמעה ללא הפסקות גם כבחירה אומנותית וגם כתוצר של תקליטי ויניל ותקליטורים שבהם האודיו נכתב כסטרימינג רציף אחד. לצערנו, בגלל האופן שבו פועלים קודקים מודרניים של אודיו כמו MP3 ו-AAC, חוויית ההאזנה הרציפה הזו כבר לא קיימת היום.
בהמשך נסביר למה, אבל בינתיים נתחיל בהדגמה. בהמשך מוצגות 30 השניות הראשונות של הסרטון המצוין Sintel, שחולק ל-5 קובצי MP3 נפרדים והורכב מחדש באמצעות MSE. הקווים האדומים מציינים פערים שנוצרו במהלך היצירה (הקידוד) של כל קובץ MP3. בנקודות האלה תשמעו תקלות.
איכס! זו לא חוויה טובה, ואנחנו יכולים לשפר אותה. עם קצת יותר עבודה, באמצעות אותם קובצי MP3 בדיוק בהדגמה שלמעלה, אנחנו יכולים להשתמש ב-MSE כדי להסיר את הפערים המעצבנים האלה. הקווים הירוקים בהדגמה הבאה מציינים את המקומות שבהם הקבצים חוברו והפערים הוסרו. ב-Chrome 38 ואילך, ההפעלה תתבצע בצורה חלקה.
יש מגוון דרכים ליצור תוכן ללא הפסקות. לצורך ההדגמה הזו, נתמקד בסוג הקבצים שיכולים להיות למשתמש רגיל. כל קובץ קודד בנפרד, בלי להתחשב בקטעי האודיו שלפניו או אחריו.
הגדרה בסיסית
קודם נחזור אחורה ונסביר איך מגדירים מכונה בסיסית של MediaSource.
כמו שהשם מרמז, Media Source Extensions הן רק תוספים לרכיבי המדיה הקיימים. בדוגמה הבאה, אנחנו מקצים Object URL שמייצג את המכונה של MediaSource למאפיין המקור של רכיב אודיו, בדיוק כמו שמגדירים כתובת URL רגילה.
var audio = document.createElement('audio');
var mediaSource = new MediaSource();
var SEGMENTS = 5;

mediaSource.addEventListener('sourceopen', function () {
  var sourceBuffer = mediaSource.addSourceBuffer('audio/mpeg');

  function onAudioLoaded(data, index) {
    // Append the ArrayBuffer data into our new SourceBuffer.
    sourceBuffer.appendBuffer(data);
  }

  // Retrieve an audio segment via XHR.  For simplicity, we're retrieving the
  // entire segment at once, but we could also retrieve it in chunks and append
  // each chunk separately.  MSE will take care of assembling the pieces.
  GET('sintel/sintel_0.mp3', function (data) {
    onAudioLoaded(data, 0);
  });
});

audio.src = URL.createObjectURL(mediaSource);
אחרי שהאובייקט MediaSource מחובר, הוא מבצע אתחול ובסופו של דבר מפעיל אירוע sourceopen. בשלב הזה אפשר ליצור SourceBuffer. בדוגמה שלמעלה, אנחנו יוצרים רכיב audio/mpeg, שיכול לנתח ולפענח את קטעי ה-MP3 שלנו. יש עוד כמה סוגים זמינים.
צורות גל חריגות
נחזור לקוד עוד רגע, אבל עכשיו נסתכל מקרוב על הקובץ שהוספנו, במיוחד בסוף שלו. למטה מוצג תרשים של 3,000 הדגימות האחרונות, כממוצע של שני הערוצים מהטראק sintel_0.mp3. כל פיקסל בקו האדום הוא דגימה של נקודה צפה בטווח של [-1.0, 1.0].

מה פשר כל הדגימות האלה של אפס (שקט)?! הן למעשה נובעות מארטיפקטים של דחיסה שנוצרו במהלך הקידוד. כמעט כל מקודד מוסיף ריפוד מסוג כלשהו. במקרה הזה, LAME הוסיף בדיוק 576 דגימות ריפוד לסוף הקובץ.
בנוסף לריפוד בסוף, לכל קובץ נוסף גם ריפוד בהתחלה. אם נציץ קדימה בטראק
sintel_1.mp3
נראה שיש עוד 576 דגימות של ריפוד בהתחלה. כמות הריפוד משתנה בהתאם למקודד ולתוכן, אבל אנחנו יודעים את הערכים המדויקים על סמך metadata שכלול בכל קובץ.
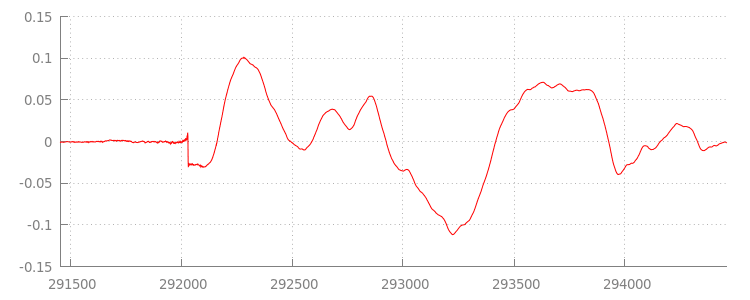
הקטעים השקטים בתחילת ובסוף כל קובץ הם אלה שגורמים לתקלות בין הקטעים בהדגמה הקודמת. כדי להשיג הפעלה ללא הפסקות, אנחנו צריכים להסיר את קטעי השקט האלה. למזלכם, קל לעשות את זה באמצעות MediaSource. בהמשך נשנה את ה-method onAudioLoaded() כדי להשתמש בחלון הוספה ובהיסט חותמת זמן כדי להסיר את השתיקה הזו.
קוד לדוגמה
function onAudioLoaded(data, index) {
  // Parsing gapless metadata is unfortunately non trivial and a bit messy, so
  // we'll glaze over it here; see the appendix for details.
  // ParseGaplessData() will return a dictionary with two elements:
  //
  //    audioDuration: Duration in seconds of all non-padding audio.
  //    frontPaddingDuration: Duration in seconds of the front padding.
  //
  var gaplessMetadata = ParseGaplessData(data);

  // Each appended segment must be appended relative to the next.  To avoid any
  // overlaps, we'll use the end timestamp of the last append as the starting
  // point for our next append or zero if we haven't appended anything yet.
  var appendTime = index > 0 ? sourceBuffer.buffered.end(0) : 0;

  // Simply put, an append window allows you to trim off audio (or video) frames
  // which fall outside of a specified time range.  Here, we'll use the end of
  // our last append as the start of our append window and the end of the real
  // audio data for this segment as the end of our append window.
  sourceBuffer.appendWindowStart = appendTime;
  sourceBuffer.appendWindowEnd = appendTime + gaplessMetadata.audioDuration;

  // The timestampOffset field essentially tells MediaSource where in the media
  // timeline the data given to appendBuffer() should be placed.  I.e., if the
  // timestampOffset is 1 second, the appended data will start 1 second into
  // playback.
  //
  // MediaSource requires that the media timeline starts from time zero, so we
  // need to ensure that the data left after filtering by the append window
  // starts at time zero.  We'll do this by shifting all of the padding we want
  // to discard before our append time (and thus, before our append window).
  sourceBuffer.timestampOffset =
    appendTime - gaplessMetadata.frontPaddingDuration;

  // When appendBuffer() completes, it will fire an updateend event signaling
  // that it's okay to append another segment of media.  Here, we'll chain the
  // append for the next segment to the completion of our current append.
  if (index == 0) {
    sourceBuffer.addEventListener('updateend', function () {
      if (++index < SEGMENTS) {
        GET('sintel/sintel_' + index + '.mp3', function (data) {
          onAudioLoaded(data, index);
        });
      } else {
        // We've loaded all available segments, so tell MediaSource there are no
        // more buffers which will be appended.
        mediaSource.endOfStream();
        URL.revokeObjectURL(audio.src);
      }
    });
  }

  // appendBuffer() will now use the timestamp offset and append window settings
  // to filter and timestamp the data we're appending.
  //
  // Note: While this demo uses very little memory, more complex use cases need
  // to be careful about memory usage or garbage collection may remove ranges of
  // media in unexpected places.
  sourceBuffer.appendBuffer(data);
}
צורת גל חלקה
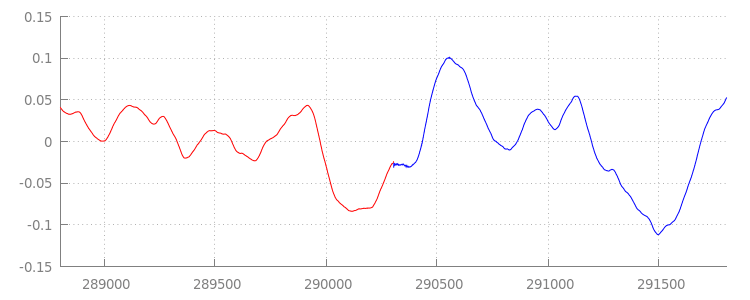
בואו נראה מה הקוד החדש והמבריק שלנו השיג, על ידי מבט נוסף על צורת הגל אחרי שהחלנו את חלונות ההוספה. בתמונה הבאה אפשר לראות שהקטע השקט בסוף של sintel_0.mp3 (באדום) והקטע השקט בתחילת sintel_1.mp3 (בכחול) הוסרו, וכך נוצר מעבר חלק בין הקטעים.
סיכום
עכשיו חיברנו את כל חמשת הקטעים בצורה חלקה לאחד, והגענו לסוף ההדגמה. לפני שנסיים, אולי שמתם לב שהשיטה onAudioLoaded() לא מתייחסת למאגרים או לקודקים.
כלומר, כל השיטות האלה יפעלו בלי קשר לסוג הקונטיינר או ה-codec. בהמשך אפשר להפעיל מחדש את קובץ ה-MP4 המקורי המקוטע שמוכן ל-DASH במקום MP3.
אם אתם רוצים לדעת יותר, אתם יכולים לעיין בנספחים שבהמשך כדי לקבל מידע נוסף על יצירת תוכן ללא הפסקות ועל ניתוח מטא-נתונים. אתם יכולים גם לעיין ב-gapless.js כדי לבחון מקרוב את הקוד שמפעיל את ההדגמה הזו.
תודה על שקראת מידע זה!
נספח א': יצירת תוכן ללא הפסקות
לא קל ליצור תוכן ללא רווחים. בהמשך נסביר איך ליצור את המדיה של Sintel שבה השתמשנו בהדגמה הזו. כדי להתחיל, צריך עותק של פסקול FLAC ללא אובדן מידע של Sintel. למטרות תיעוד, ה-SHA1 כלול בהמשך. הכלים שצריך הם FFmpeg, MP4Box, LAME והתקנת OSX עם afconvert.
    unzip Jan_Morgenstern-Sintel-FLAC.zip
    sha1sum 1-Snow_Fight.flac
    # 0535ca207ccba70d538f7324916a3f1a3d550194  1-Snow_Fight.flac
קודם נפצל את 31.5 השניות הראשונות של הטראק 1-Snow_Fight.flac. אנחנו רוצים גם להוסיף דעיכה של 2.5 שניות שמתחילה ב-28 שניות, כדי למנוע קליקים אחרי שההפעלה מסתיימת. באמצעות שורת הפקודה של FFmpeg שבהמשך, אפשר לבצע את כל הפעולות האלה ולהכניס את התוצאות לקובץ sintel.flac.
ffmpeg -i 1-Snow_Fight.flac -t 31.5 -af "afade=t=out:st=28:d=2.5" sintel.flac
בשלב הבא, נפצל את הקובץ ל-5 קובצי wave באורך 6.5 שניות כל אחד. הכי קל להשתמש ב-wave כי כמעט כל מקודד תומך בהטמעה שלו. גם את זה אפשר לעשות בצורה מדויקת עם FFmpeg, ואז יהיו לנו הקבצים: sintel_0.wav, sintel_1.wav, sintel_2.wav, sintel_3.wav ו-sintel_4.wav.
    ffmpeg -i sintel.flac -acodec pcm_f32le -map 0 -f segment \
           -segment_list out.list -segment_time 6.5 sintel_%d.wav
עכשיו ניצור את קובצי ה-MP3. ב-LAME יש כמה אפשרויות ליצירת תוכן ללא הפסקות. אם התוכן בשליטתך, כדאי לשקול להשתמש ב---nogap עם קידוד באצווה של כל הקבצים כדי להימנע לחלוטין מהוספת רווחים בין הקטעים.
אבל לצורך ההדגמה הזו, אנחנו רוצים את הריפוד הזה, אז נשתמש בקידוד VBR סטנדרטי באיכות גבוהה של קובצי ה-wave.
    lame -V=2 sintel_0.wav sintel_0.mp3
    lame -V=2 sintel_1.wav sintel_1.mp3
    lame -V=2 sintel_2.wav sintel_2.mp3
    lame -V=2 sintel_3.wav sintel_3.mp3
    lame -V=2 sintel_4.wav sintel_4.mp3
זה כל מה שצריך כדי ליצור את קובצי ה-MP3. עכשיו נסביר איך ליצור קובצי MP4 מקוטעים. אנחנו נפעל לפי ההוראות של אפל ליצירת מדיה שמותאמת ל-iTunes. בהמשך נמיר את קובצי ה-WAVE לקובצי CAF זמניים, בהתאם להוראות, לפני שנקודד אותם כ-AAC במאגר MP4 באמצעות הפרמטרים המומלצים.
    afconvert sintel_0.wav sintel_0_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_1.wav sintel_1_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_2.wav sintel_2_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_3.wav sintel_3_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_4.wav sintel_4_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_0_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_0.m4a
    afconvert sintel_1_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_1.m4a
    afconvert sintel_2_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_2.m4a
    afconvert sintel_3_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_3.m4a
    afconvert sintel_4_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_4.m4a
עכשיו יש לנו כמה קובצי M4A שצריך לפצל כמו שצריך לפני שאפשר יהיה להשתמש בהם עם MediaSource. למטרות שלנו, נשתמש בגודל מקטע של שנייה אחת. MP4Box יכתוב כל קובץ MP4 מקוטע בתור sintel_#_dashinit.mp4, יחד עם מניפסט MPEG-DASH (sintel_#_dash.mpd) שאפשר למחוק.
    MP4Box -dash 1000 sintel_0.m4a && mv sintel_0_dashinit.mp4 sintel_0.mp4
    MP4Box -dash 1000 sintel_1.m4a && mv sintel_1_dashinit.mp4 sintel_1.mp4
    MP4Box -dash 1000 sintel_2.m4a && mv sintel_2_dashinit.mp4 sintel_2.mp4
    MP4Box -dash 1000 sintel_3.m4a && mv sintel_3_dashinit.mp4 sintel_3.mp4
    MP4Box -dash 1000 sintel_4.m4a && mv sintel_4_dashinit.mp4 sintel_4.mp4
    rm sintel_{0,1,2,3,4}_dash.mpd
זהו! עכשיו יש לנו קובצי MP4 ו-MP3 מקוטעים עם המטא-נתונים הנכונים שנדרשים להפעלה רציפה. בנספח ב' מפורט איך נראים המטא-נתונים האלה.
נספח ב': ניתוח מטא-נתונים ללא הפסקות
בדיוק כמו יצירת תוכן ללא פערים, ניתוח המטא-נתונים ללא פערים יכול להיות מסובך כי אין שיטה סטנדרטית לאחסון. בהמשך נסביר איך שני המקודדים הנפוצים ביותר, LAME ו-iTunes, מאחסנים את המטא-נתונים שלהם ללא רווחים. נתחיל בהגדרה של כמה שיטות עזר ומתאר ל-ParseGaplessData() שבו השתמשנו למעלה.
    // Since most MP3 encoders store the gapless metadata in binary, we'll need a
    // method for turning bytes into integers.  Note: This doesn't work for values
    // larger than 2^30 since we'll overflow the signed integer type when shifting.
    function ReadInt(buffer) {
      var result = buffer.charCodeAt(0);
      for (var i = 1; i < buffer.length; ++i) {
        result <<= 8;
        result += buffer.charCodeAt(i);
      }
      return result;
    }

    function ParseGaplessData(arrayBuffer) {
      // Gapless data is generally within the first 512 bytes, so limit parsing.
      var byteStr = new TextDecoder().decode(arrayBuffer.slice(0, 512));

      var frontPadding = 0, endPadding = 0, realSamples = 0;

      // ... we'll fill this in as we go below.
קודם נסביר על פורמט המטא-נתונים של iTunes של אפל, כי הוא הכי קל לניתוח ולהסבר. בקובצי MP3 ו-M4A, iTunes (ו-afconvert) כותב קטע קצר ב-ASCII, כך:
iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00
המידע הזה נכתב בתוך תג ID3 במאגר MP3 ובתוך עדכון Atom של מטא-נתונים במאגר MP4. למטרות שלנו, אנחנו יכולים להתעלם מהאסימון הראשון של 0000000. שלושת האסימונים הבאים הם הריפוד הקדמי, הריפוד האחורי ומספר הדגימות הכולל ללא ריפוד. אם נחלק כל אחד מהם בתדירות הדגימה של האודיו, נקבל את משך הזמן של כל אחד מהם.
// iTunes encodes the gapless data as hex strings like so:
//
//    'iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00'
//    'iTunSMPB[ 26 bytes ]####### frontpad  endpad    real samples'
//
// The approach here elides the complexity of actually parsing MP4 atoms. It
// may not work for all files without some tweaks.
var iTunesDataIndex = byteStr.indexOf('iTunSMPB');
if (iTunesDataIndex != -1) {
  var frontPaddingIndex = iTunesDataIndex + 34;
  frontPadding = parseInt(byteStr.substr(frontPaddingIndex, 8), 16);

  var endPaddingIndex = frontPaddingIndex + 9;
  endPadding = parseInt(byteStr.substr(endPaddingIndex, 8), 16);

  var sampleCountIndex = endPaddingIndex + 9;
  realSamples = parseInt(byteStr.substr(sampleCountIndex, 16), 16);
}
מצד שני, רוב המקודדים של MP3 בקוד פתוח יאחסנו את המטא-נתונים של ההשמעה ללא הפסקות בתוך כותרת Xing מיוחדת, שמוצבת בתוך פריים MPEG שקט (הוא שקט כדי שמפענחים שלא מבינים את כותרת ה-Xing פשוט ישמיעו שקט). לצערנו, התג הזה לא תמיד קיים ויש לו כמה שדות אופציונליים. לצורך ההדגמה הזו, יש לנו שליטה על המדיה, אבל בפועל נדרשות כמה בדיקות נוספות כדי לדעת מתי המטא-נתונים של Gapless זמינים בפועל.
קודם ננתח את מספר הדגימות הכולל. כדי לפשט את הדברים, נקרא את זה מכותרת Xing, אבל אפשר לבנות את זה מכותרת האודיו הרגילה של MPEG.
כותרות Xing יכולות להיות מסומנות בתג Xing או Info. בדיוק 4 בייטים אחרי התג הזה יש 32 ביטים שמייצגים את המספר הכולל של הפריימים בקובץ. אם נכפיל את הערך הזה במספר הדגימות לכל פריים, נקבל את סך הדגימות בקובץ.
    // Xing padding is encoded as 24bits within the header.  Note: This code will
    // only work for Layer3 Version 1 and Layer2 MP3 files with XING frame counts
    // and gapless information.  See the following document for more details:
    // http://www.codeproject.com/Articles/8295/MPEG-Audio-Frame-Header
    var xingDataIndex = byteStr.indexOf('Xing');
    if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Info');
    if (xingDataIndex != -1) {
      // See section 2.3.1 in the link above for the specifics on parsing the Xing
      // frame count.
      var frameCountIndex = xingDataIndex + 8;
      var frameCount = ReadInt(byteStr.substr(frameCountIndex, 4));

      // For Layer3 Version 1 and Layer2 there are 1152 samples per frame.  See
      // section 2.1.5 in the link above for more details.
      var paddedSamples = frameCount * 1152;

      // ... we'll cover this below.
עכשיו, כשיש לנו את המספר הכולל של הדגימות, אנחנו יכולים להמשיך לקרוא את מספר דגימות הריפוד. בהתאם למקודד, יכול להיות שהמידע הזה ייכתב בתג LAME או Lavf שמוטמע בכותרת Xing. בדיוק 17 בייטים אחרי הכותרת הזו יש 3 בייטים שמייצגים את הריפוד הקדמי והאחורי ב-12 ביטים כל אחד, בהתאמה.
        xingDataIndex = byteStr.indexOf('LAME');
        if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Lavf');
        if (xingDataIndex != -1) {
          // See http://gabriel.mp3-tech.org/mp3infotag.html#delays for details of
          // how this information is encoded and parsed.
          var gaplessDataIndex = xingDataIndex + 21;
          var gaplessBits = ReadInt(byteStr.substr(gaplessDataIndex, 3));

          // Upper 12 bits are the front padding, lower are the end padding.
          frontPadding = gaplessBits >> 12;
          endPadding = gaplessBits & 0xFFF;
        }

        realSamples = paddedSamples - (frontPadding + endPadding);
      }

      return {
        audioDuration: realSamples * SECONDS_PER_SAMPLE,
        frontPaddingDuration: frontPadding * SECONDS_PER_SAMPLE
      };
    }
עכשיו יש לנו פונקציה שלמה לניתוח של רוב התוכן ללא הפסקות. עם זאת, יש הרבה מקרי קצה, ולכן מומלץ להיזהר לפני שמשתמשים בקוד דומה בסביבת הייצור.
נספח ג': על מנגנון איסוף הזבל
זיכרון השייך למופעים של נאסף באופן פעיל כזבל בהתאם לסוג התוכן, מגבלות ספציפיות לפלטפורמה ומיקום ההפעלה הנוכחי. ב-Chrome, הזיכרון יפונה קודם ממאגרי נתונים שכבר הופעלו. עם זאת, אם השימוש בזיכרון חורג מהמגבלות הספציפיות של הפלטפורמה, הוא יסיר את הזיכרון ממאגרים שלא הופעלו.
כשההפעלה מגיעה לפער בציר הזמן בגלל זיכרון שהוחזר, יכול להיות שתהיה תקלה אם הפער קטן מספיק, או שההפעלה תיתקע לגמרי אם הפער גדול מדי. אף אחת מהאפשרויות האלה לא מספקת חוויית משתמש טובה, ולכן חשוב להימנע מהוספה של יותר מדי נתונים בבת אחת, ולהסיר באופן ידני טווחים מציר הזמן של המדיה שכבר לא נחוצים.
אפשר להסיר טווחים באמצעות השיטה remove() בכל SourceBuffer, שמקבלת טווח [start, end] בשניות.
בדומה ל-appendBuffer(), כל remove() יפעיל אירוע updateend בסיום. אין להוציא פעולות הסרה או הוספה אחרות עד שהאירוע מופעל.
בגרסת Chrome למחשב, אפשר לשמור בזיכרון בערך 12 מגה-בייט של תוכן אודיו ו-150 מגה-בייט של קטע וידאו בו-זמנית. אל תסתמכו על הערכים האלה בדפדפנים או בפלטפורמות שונות. למשל, הם בטוח לא מייצגים מכשירים ניידים.
איסוף האשפה משפיע רק על נתונים שנוספו אל SourceBuffers. אין מגבלות על כמות הנתונים שאפשר לשמור במאגר נתונים זמני במשתני JavaScript. במקרה הצורך, אפשר גם להוסיף מחדש את אותם הנתונים באותו מיקום.