


مقدمه
افزونههای منبع رسانه (MSE)
بافرینگ گسترده و کنترل بازپخش را برای عناصر HTML5 <audio> و
<video> ارائه میدهند. درحالیکه در ابتدا برای تسهیل پخشکنندههای ویدیویی مبتنی بر
جاریسازی تطبیقی پویا ازطریق HTTP (DASH)
توسعه یافته بود، در زیر خواهیم دید که چگونه میتوان از آنها برای صدا استفاده کرد؛ بهویژه برای
بازپخش بدون وقفه.
احتمالاً به آلبوم موسیقیای گوش دادهاید که آهنگها بهطور یکپارچه در سراسر قطعهها جریان داشتهاند؛ حتی ممکن است همین حالا درحال گوش دادن به یکی از آنها باشید. هنرمندان این تجربههای بازپخش بدون وقفه را هم بهعنوان یک انتخاب هنری و هم بهعنوان محصولی از صفحههای گرامافون و سیدیها ایجاد میکنند که در آنها صدا بهصورت یک جریان پیوسته نوشته میشد. متأسفانه بهدلیل نحوه عملکرد کدکهای صوتی مدرن مانند MP3 و AAC، این تجربه شنیداری یکپارچه امروزه اغلب ازبین میرود.
در زیر به جزئیات دلیل آن میپردازیم، اما فعلاً بیایید با یک نمایش شروع کنیم. در زیر، سی ثانیه اول فیلم عالی Sintel به پنج فایل MP3 جداگانه تقسیم شده و بااستفاده از MSE دوباره مونتاژ شده است. خطوط قرمز نشاندهنده وقفههایی است که درطول ساخت (کدبندی) هر MP3 ایجاد شده است؛ در این نقاط، اشکالاتی خواهید شنید.
اه! این تجربه خوبی نیست؛ میتوانیم بهتر عمل کنیم. با کمی کار بیشتر، بااستفاده از همان فایلهای MP3 در نسخه نمایشی بالا، میتوانیم از MSE برای حذف آن وقفههای آزاردهنده استفاده کنیم. خطوط سبز در نسخه نمایشی بعدی نشان میدهد که فایلها کجا به هم پیوستهاند و فاصلهها برداشته شدهاند. در Chrome نسخه ۳۸ و بالاتر، این ویدیو بهصورت یکپارچه پخش خواهد شد!
روشهای مختلفی برای ایجاد محتوای بدون وقفه وجود دارد. برای اهداف این نسخه نمایشی، ما روی نوع فایلهایی تمرکز میکنیم که یک کاربر عادی ممکن است در اطراف خود داشته باشد. که در آن هر فایل بهطور جداگانه و بدون توجه به بخشهای صوتی قبل یا بعداز آن کدگذاری شده است.
راهاندازی پایه
ابتدا، بیایید به عقب برگردیم و راهاندازی اولیه نمونه MediaSource را پوشش دهیم.
افزونههای منبع رسانه، همانطور که از نامشان پیداست، فقط افزونههایی برای عناصر رسانه موجود هستند. در زیر،
Object URL را که نشاندهنده نمونه MediaSource ما است به مشخصه منبع عنصر صوتی اختصاص میدهیم؛ درست مثل زمانی که نشانی وب استانداردی را تنظیم میکنید.
var audio = document.createElement('audio');
var mediaSource = new MediaSource();
var SEGMENTS = 5;

mediaSource.addEventListener('sourceopen', function () {
  var sourceBuffer = mediaSource.addSourceBuffer('audio/mpeg');

  function onAudioLoaded(data, index) {
    // Append the ArrayBuffer data into our new SourceBuffer.
    sourceBuffer.appendBuffer(data);
  }

  // Retrieve an audio segment via XHR.  For simplicity, we're retrieving the
  // entire segment at once, but we could also retrieve it in chunks and append
  // each chunk separately.  MSE will take care of assembling the pieces.
  GET('sintel/sintel_0.mp3', function (data) {
    onAudioLoaded(data, 0);
  });
});

audio.src = URL.createObjectURL(mediaSource);
وقتی شیء MediaSource متصل شد، مقداری مقداردهی اولیه انجام میدهد
و درنهایت رویداد sourceopen را فعال میکند؛ در این مرحله میتوانیم
SourceBuffer ایجاد کنیم. در مثال بالا، ما یک audio/mpeg ایجاد میکنیم که قادر به تجزیه و رمزگشایی بخشهای MP3 ما است؛ چندین نوع دیگر نیز دردسترس است.
شکل موجهای غیرعادی
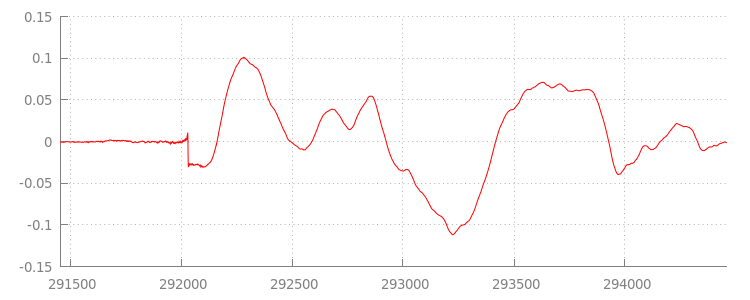
لحظاتی دیگر به کد برمیگردیم، اما اکنون بیایید نگاه دقیقتری به فایلی که بهتازگی پیوست کردهایم، بهویژه در انتهای آن، بیندازیم. در زیر، نموداری از
میانگین ۳۰۰۰ نمونه آخر در هر دو کانال از
قطعه
sintel_0.mp3
آمده است. هر پیکسل روی خط قرمز یک
نمونه نقطه شناور
در محدوده [-1.0, 1.0] است.

What's with all that those zero (silent) samples!? این مشکل درواقع بهدلیل مصنوعات فشردهسازی است که درطول کدبندی ایجاد شده است. تقریباً هر کدبندی نوعی از لاییگذاری را معرفی میکند. در این مورد LAME دقیقاً ۵۷۶ نمونه لایه به انتهای فایل اضافه کرد.
علاوهبر لایه اضافه در پایان، هر فایل لایه اضافهای نیز در ابتدا داشت. اگر به قطعه
sintel_1.mp3
نگاهی بیندازیم، میبینیم که ۵۷۶ نمونه دیگر از لایهگذاری در جلو وجود دارد. مقدار
حاشیه داخلی بسته به کدبند و محتوا متفاوت است، اما ما مقادیر دقیق را براساس
metadata موجود در هر فایل میدانیم.
بخشهای سکوت در ابتدا و انتهای هر فایل باعث ایجاد
اشکال بین بخشها در نسخه نمایشی قبلی میشود. برای دستیابی به بازپخش بدون وقفه،
باید این بخشهای سکوت را برداریم. خوشبختانه این کار بهراحتی با
MediaSource انجام میشود. در زیر، روش onAudioLoaded() خود را اصلاح میکنیم تا از
پنجره الحاق و مُهر زمان
انحراف برای حذف این سکوت استفاده کنیم.
کد نمونه
function onAudioLoaded(data, index) {
  // Parsing gapless metadata is unfortunately non trivial and a bit messy, so
  // we'll glaze over it here; see the appendix for details.
  // ParseGaplessData() will return a dictionary with two elements:
  //
  //    audioDuration: Duration in seconds of all non-padding audio.
  //    frontPaddingDuration: Duration in seconds of the front padding.
  //
  var gaplessMetadata = ParseGaplessData(data);

  // Each appended segment must be appended relative to the next.  To avoid any
  // overlaps, we'll use the end timestamp of the last append as the starting
  // point for our next append or zero if we haven't appended anything yet.
  var appendTime = index > 0 ? sourceBuffer.buffered.end(0) : 0;

  // Simply put, an append window allows you to trim off audio (or video) frames
  // which fall outside of a specified time range.  Here, we'll use the end of
  // our last append as the start of our append window and the end of the real
  // audio data for this segment as the end of our append window.
  sourceBuffer.appendWindowStart = appendTime;
  sourceBuffer.appendWindowEnd = appendTime + gaplessMetadata.audioDuration;

  // The timestampOffset field essentially tells MediaSource where in the media
  // timeline the data given to appendBuffer() should be placed.  I.e., if the
  // timestampOffset is 1 second, the appended data will start 1 second into
  // playback.
  //
  // MediaSource requires that the media timeline starts from time zero, so we
  // need to ensure that the data left after filtering by the append window
  // starts at time zero.  We'll do this by shifting all of the padding we want
  // to discard before our append time (and thus, before our append window).
  sourceBuffer.timestampOffset =
    appendTime - gaplessMetadata.frontPaddingDuration;

  // When appendBuffer() completes, it will fire an updateend event signaling
  // that it's okay to append another segment of media.  Here, we'll chain the
  // append for the next segment to the completion of our current append.
  if (index == 0) {
    sourceBuffer.addEventListener('updateend', function () {
      if (++index < SEGMENTS) {
        GET('sintel/sintel_' + index + '.mp3', function (data) {
          onAudioLoaded(data, index);
        });
      } else {
        // We've loaded all available segments, so tell MediaSource there are no
        // more buffers which will be appended.
        mediaSource.endOfStream();
        URL.revokeObjectURL(audio.src);
      }
    });
  }

  // appendBuffer() will now use the timestamp offset and append window settings
  // to filter and timestamp the data we're appending.
  //
  // Note: While this demo uses very little memory, more complex use cases need
  // to be careful about memory usage or garbage collection may remove ranges of
  // media in unexpected places.
  sourceBuffer.appendBuffer(data);
}
شکل موج یکپارچه
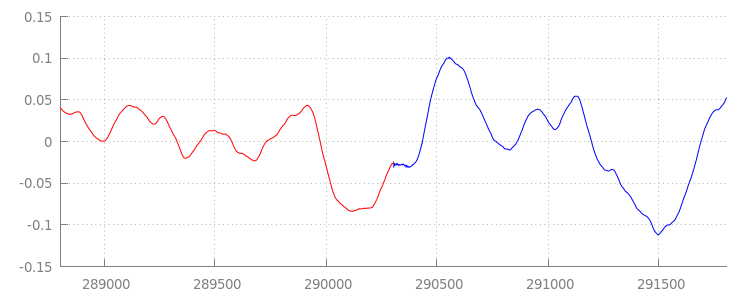
بیایید ببینیم کد جدید و درخشان ما با نگاهی دوباره به شکل موج پساز اعمال پنجرههای الحاق ما چه چیزی را انجام داده است. در زیر، میتوانید ببینید که
بخش بیصدا در انتهای
sintel_0.mp3
(به رنگ قرمز) و بخش بیصدا در ابتدای
sintel_1.mp3
(به رنگ آبی) برداشته شدهاند؛
و درنتیجه انتقال یکپارچهای بین بخشها ایجاد شده است.
نتیجهگیری
با این کار، هر پنج بخش را بهطور یکپارچه به هم متصل کردهایم و
درنتیجه به پایان نسخه نمایشی خود رسیدهایم. قبلاز اینکه برویم، ممکن است متوجه شده باشید
که روش onAudioLoaded() ما هیچ توجهی به محفظهها یا کدکها ندارد.
یعنی همه این تکنیکها صرفنظر از نوع محفظه یا کدک کار خواهند کرد. در زیر میتوانید MP4 تکهتکهشده آماده DASH نمایشی اصلی را بهجای MP3 بازپخش کنید.
اگر میخواهید اطلاعات بیشتری کسب کنید، برای نگاهی عمیقتر به ایجاد محتوای بدون وقفه و تجزیه فراداده، پیوستهای زیر را بررسی کنید. همچنین میتوانید
gapless.js را کاوش کنید تا نگاهی دقیقتر به
کد پشتیبان این نسخه نمایشی داشته باشید.
از اینکه خواندید سپاسگزاریم!
پیوست الف: ایجاد محتوای بدون وقفه
ایجاد محتوای بدون وقفه ممکن است دشوار باشد. در زیر، مراحل ایجاد رسانه Sintel را که در این نسخه نمایشی استفاده شده است مرور میکنیم. برای شروع، به نسخهای از موسیقی متن FLAC بیاتلاف برای Sintel نیاز دارید؛ برای آیندگان، SHA1 در زیر گنجانده شده است. برای ابزارها، به FFmpeg، MP4Box، LAME، و نصب OSX با afconvert نیاز دارید.
    unzip Jan_Morgenstern-Sintel-FLAC.zip
    sha1sum 1-Snow_Fight.flac
    # 0535ca207ccba70d538f7324916a3f1a3d550194  1-Snow_Fight.flac
ابتدا، ۳۱.۵ ثانیه اول قطعه 1-Snow_Fight.flac را جدا میکنیم. همچنین میخواهیم یک محو تدریجی ۲.۵ ثانیهای را از ثانیه ۲۸ اضافه کنیم تا از هرگونه کلیک پساز پایان پخش جلوگیری شود. بااستفاده از خط فرمان FFmpeg زیر میتوانیم
همه این کارها را انجام دهیم و نتایج را در sintel.flac قرار دهیم.
ffmpeg -i 1-Snow_Fight.flac -t 31.5 -af "afade=t=out:st=28:d=2.5" sintel.flac
سپس، فایل را به ۵ فایل wave
هرکدام بهمدت ۶٫۵ ثانیه تقسیم میکنیم؛ استفاده از wave آسانترین راه است زیرا تقریباً همه کدبندها
از انتقال آن پشتیبانی میکنند. باز هم میتوانیم این کار را دقیقاً با FFmpeg انجام دهیم،
که پساز آن خواهیم داشت: sintel_0.wav، sintel_1.wav، sintel_2.wav،
sintel_3.wav، و sintel_4.wav.
    ffmpeg -i sintel.flac -acodec pcm_f32le -map 0 -f segment \
           -segment_list out.list -segment_time 6.5 sintel_%d.wav
سپس، بیایید فایلهای MP3 را بسازیم. LAME چندین گزینه برای ایجاد محتوای
بدون وقفه دارد. اگر کنترل محتوا را دراختیار دارید، میتوانید از --nogap
با کدگذاری دستهای همه فایلها استفاده کنید تا از ایجاد فاصله بین بخشها بهطور کامل جلوگیری کنید.
اما برای اهداف این نسخه نمایشی، ما آن لایه را میخواهیم، بنابراین از کدبندی VBR استاندارد با کیفیت بالا برای فایلهای موجی استفاده خواهیم کرد.
    lame -V=2 sintel_0.wav sintel_0.mp3
    lame -V=2 sintel_1.wav sintel_1.mp3
    lame -V=2 sintel_2.wav sintel_2.mp3
    lame -V=2 sintel_3.wav sintel_3.mp3
    lame -V=2 sintel_4.wav sintel_4.mp3
این تنها کاری است که برای ایجاد فایلهای MP3 لازم است. اکنون بیایید به ایجاد فایلهای MP4 تکهتکهشده بپردازیم. ما از دستورالعملهای Apple برای ایجاد رسانهای که برای iTunes مستر شده است پیروی میکنیم. در زیر، فایلهای wave را طبق دستورالعملها به فایلهای واسطه CAF تبدیل میکنیم و سپس آنها را بااستفاده از پارامترهای توصیهشده بهصورت AAC در محفظه MP4 کدبندی میکنیم.
    afconvert sintel_0.wav sintel_0_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_1.wav sintel_1_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_2.wav sintel_2_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_3.wav sintel_3_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_4.wav sintel_4_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_0_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_0.m4a
    afconvert sintel_1_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_1.m4a
    afconvert sintel_2_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_2.m4a
    afconvert sintel_3_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_3.m4a
    afconvert sintel_4_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_4.m4a
اکنون چند فایل M4A داریم که باید آنها را بهدرستی
تکهتکه کنیم
تا بتوانیم از آنها با
MediaSource استفاده کنیم. برای اهداف ما، از اندازه قطعه یک ثانیه استفاده خواهیم کرد. MP4Box
هر MP4 تکهتکهشده را بهصورت sintel_#_dashinit.mp4 بههمراه یک
مانیفست MPEG-DASH (sintel_#_dash.mpd) که میتوان آن را دور انداخت، مینویسد.
    MP4Box -dash 1000 sintel_0.m4a && mv sintel_0_dashinit.mp4 sintel_0.mp4
    MP4Box -dash 1000 sintel_1.m4a && mv sintel_1_dashinit.mp4 sintel_1.mp4
    MP4Box -dash 1000 sintel_2.m4a && mv sintel_2_dashinit.mp4 sintel_2.mp4
    MP4Box -dash 1000 sintel_3.m4a && mv sintel_3_dashinit.mp4 sintel_3.mp4
    MP4Box -dash 1000 sintel_4.m4a && mv sintel_4_dashinit.mp4 sintel_4.mp4
    rm sintel_{0,1,2,3,4}_dash.mpd
فقط همین! اکنون فایلهای MP4 و MP3 تکهتکهشده با فراداده صحیح لازم برای بازپخش بدون وقفه را داریم. برای جزئیات بیشتر درباره اینکه این فراداده دقیقاً چه شکلی است، به پیوست «ب» مراجعه کنید.
ضمیمه ب: تجزیه فرادادههای بدون وقفه
درست مانند ایجاد محتوای بدون وقفه، تجزیه فرادادههای بدون وقفه میتواند دشوار باشد
زیرا روش استانداردی برای ذخیرهسازی وجود ندارد. در زیر نحوه ذخیره فرادادههای بدون وقفه توسط دو کدبند رایج، LAME و iTunes، را توضیح میدهیم. بیایید با راهاندازی چند روش کمکی و طرح کلی برای ParseGaplessData() استفادهشده در بالا شروع کنیم.
    // Since most MP3 encoders store the gapless metadata in binary, we'll need a
    // method for turning bytes into integers.  Note: This doesn't work for values
    // larger than 2^30 since we'll overflow the signed integer type when shifting.
    function ReadInt(buffer) {
      var result = buffer.charCodeAt(0);
      for (var i = 1; i < buffer.length; ++i) {
        result <<= 8;
        result += buffer.charCodeAt(i);
      }
      return result;
    }

    function ParseGaplessData(arrayBuffer) {
      // Gapless data is generally within the first 512 bytes, so limit parsing.
      var byteStr = new TextDecoder().decode(arrayBuffer.slice(0, 512));

      var frontPadding = 0, endPadding = 0, realSamples = 0;

      // ... we'll fill this in as we go below.
ابتدا قالب فراداده iTunes متعلق به Apple را پوشش میدهیم زیرا تجزیه و توضیح آن از همه آسانتر است. در فایلهای MP3 و M4A، iTunes (و afconvert) بخش کوتاهی را در ASCII مینویسند، مانند:
iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00
این اطلاعات در برچسب ID3 در محتوای MP3 و در اتم فراداده در محتوای MP4 نوشته میشود. برای اهداف ما، میتوانیم از اولین
کد 0000000 صرفنظر کنیم. سه کد بعدی عبارتند از لایه داخلی جلو، لایه داخلی انتها، و
تعداد کل نمونههای بدون لایه داخلی. تقسیم هریک از اینها بر نرخ نمونهبرداری
صدا، مدتزمان هرکدام را به ما میدهد.
// iTunes encodes the gapless data as hex strings like so:
//
//    'iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00'
//    'iTunSMPB[ 26 bytes ]####### frontpad  endpad    real samples'
//
// The approach here elides the complexity of actually parsing MP4 atoms. It
// may not work for all files without some tweaks.
var iTunesDataIndex = byteStr.indexOf('iTunSMPB');
if (iTunesDataIndex != -1) {
  var frontPaddingIndex = iTunesDataIndex + 34;
  frontPadding = parseInt(byteStr.substr(frontPaddingIndex, 8), 16);

  var endPaddingIndex = frontPaddingIndex + 9;
  endPadding = parseInt(byteStr.substr(endPaddingIndex, 8), 16);

  var sampleCountIndex = endPaddingIndex + 9;
  realSamples = parseInt(byteStr.substr(sampleCountIndex, 16), 16);
}
ازسوی دیگر، اکثر کدبندهای MP3 متنباز فراداده بدون وقفه را در یک سرصفحه Xing ویژه ذخیره میکنند که در داخل یک قاب MPEG بیصدا قرار دارد (بیصدا است تا رمزگشاهایی که سرصفحه Xing را درک نمیکنند، بهسادگی سکوت را پخش کنند). متأسفانه این برچسب همیشه وجود ندارد و تعدادی فیلد اختیاری دارد. برای اهداف این نسخه نمایشی، ما بر رسانه کنترل داریم، اما در عمل برخی بررسیهای حساسیت اضافی لازم است تا بدانیم چه زمانی فراداده بدون وقفه واقعاً دردسترس است.
ابتدا تعداد کل نمونه را تجزیه میکنیم. برای سادگی، این را از سرصفحه Xing میخوانیم، اما میتوان آن را از سرصفحه صوتی MPEG معمولی ساخت.
سرصفحههای Xing را میتوان با برچسب Xing یا Info علامتگذاری کرد. دقیقاً ۴ بایت
بعداز این برچسب، ۳۲ بیت وجود دارد که نشاندهنده تعداد کل قابها در
فایل است؛ ضرب کردن این مقدار در تعداد نمونهها در هر قاب، تعداد کل نمونهها را در فایل به ما میدهد.
    // Xing padding is encoded as 24bits within the header.  Note: This code will
    // only work for Layer3 Version 1 and Layer2 MP3 files with XING frame counts
    // and gapless information.  See the following document for more details:
    // http://www.codeproject.com/Articles/8295/MPEG-Audio-Frame-Header
    var xingDataIndex = byteStr.indexOf('Xing');
    if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Info');
    if (xingDataIndex != -1) {
      // See section 2.3.1 in the link above for the specifics on parsing the Xing
      // frame count.
      var frameCountIndex = xingDataIndex + 8;
      var frameCount = ReadInt(byteStr.substr(frameCountIndex, 4));

      // For Layer3 Version 1 and Layer2 there are 1152 samples per frame.  See
      // section 2.1.5 in the link above for more details.
      var paddedSamples = frameCount * 1152;

      // ... we'll cover this below.
اکنون که تعداد کل نمونهها را داریم، میتوانیم به خواندن تعداد نمونههای فاصلهگذاری بپردازیم. بسته به کدبند شما، این ممکن است تحت یک برچسب LAME یا Lavf که در سرصفحه Xing قرار دارد، نوشته شود. دقیقاً ۱۷ بایت بعداز این سرصفحه ۳ بایت وجود دارد که بهترتیب نشاندهنده حاشیه داخلی جلو و عقب در ۱۲ بیت است.
        xingDataIndex = byteStr.indexOf('LAME');
        if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Lavf');
        if (xingDataIndex != -1) {
          // See http://gabriel.mp3-tech.org/mp3infotag.html#delays for details of
          // how this information is encoded and parsed.
          var gaplessDataIndex = xingDataIndex + 21;
          var gaplessBits = ReadInt(byteStr.substr(gaplessDataIndex, 3));

          // Upper 12 bits are the front padding, lower are the end padding.
          frontPadding = gaplessBits >> 12;
          endPadding = gaplessBits & 0xFFF;
        }

        realSamples = paddedSamples - (frontPadding + endPadding);
      }

      return {
        audioDuration: realSamples * SECONDS_PER_SAMPLE,
        frontPaddingDuration: frontPadding * SECONDS_PER_SAMPLE
      };
    }
با این کار، تابع کاملی برای تجزیه کردن اکثریت قاطع محتوای بدون وقفه داریم. البته موارد حاشیهای زیادی وجود دارد، بنابراین توصیه میشود قبلاز استفاده از کد مشابه در تولید، احتیاط کنید.
پیوست پ: درباره زبالهروبی
حافظه متعلق به نمونههای SourceBuffer بهطور فعال
جمعآوری زباله
میشود که براساس نوع محتوا، محدودیتهای خاص پلاتفرم، و موقعیت پخش فعلی است. در Chrome، حافظه ابتدا از میانگیرهای قبلاً پخششده بازپس گرفته میشود.
بااینحال، اگر استفاده از حافظه از محدودیتهای خاص پلاتفرم فراتر رود، حافظه را از میانگیرهای پخشنشده حذف میکند.
وقتی بازپخش بهدلیل بازیابی حافظه به وقفهای در خط زمان میرسد، اگر وقفه بهاندازه کافی کوچک باشد ممکن است دچار اشکال شود یا اگر وقفه خیلی بزرگ باشد ممکن است کاملاً متوقف شود. Neither is a great user experience, so it's important to avoid appending too much data at once and to manually remove ranges from the media timeline that are no longer necessary.
محدودهها را میتوان ازطریق
روش remove()
در هر SourceBuffer برداشت؛ که محدوده [start, end] را برحسب ثانیه میگیرد.
مشابه appendBuffer()، هر remove() یک رویداد updateend را پساز تکمیل شدن
فعال میکند. تا زمانیکه رویداد اجرا نشده است، نباید حذف یا الحاق دیگری صادر شود.
در Chrome رایانه، میتوانید بهطور همزمان تقریباً ۱۲ مگابایت محتوای صوتی و ۱۵۰ مگابایت محتوای ویدیویی را در حافظه نگه دارید. نباید به این مقادیر در مرورگرها یا پلاتفرمها اتکا کنید؛ برای مثال، این مقادیر قطعاً نماینده دستگاههای همراه نیستند.
جمعآوری زباله فقط بر دادههای اضافهشده به SourceBuffers تأثیر میگذارد؛ هیچ
محدودیتی برای مقدار دادهای که میتوانید در متغیرهای JavaScript میانگیر کنید وجود ندارد. همچنین میتوانید درصورت لزوم، همان دادهها را در همان موقعیت دوباره اضافه کنید.