


مقدمة
توفّر إضافات مصدر الوسائط (MSE) إمكانية التحكّم في التخزين المؤقت والتشغيل الموسّع لعناصر HTML5 <audio> و<video>. على الرغم من أنّ هذه الميزة تم تطويرها في الأصل لتسهيل مشغّلات الفيديو المستندة إلى البث الديناميكي التكيُّفي عبر HTTP (DASH)، سنرى أدناه كيف يمكن استخدامها للمحتوى الصوتي، وتحديدًا للتشغيل المتواصل.
من المحتمل أنّك استمعت إلى ألبوم موسيقي تتدفق فيه الأغاني بسلاسة عبر المقاطع، وربما تستمع إلى أحدها الآن. يقدّم الفنانون تجارب التشغيل المتواصل هذه كخيار فني وكأثر من أسطوانات الفينيل والأقراص المدمجة حيث تم تسجيل الصوت كبث واحد مستمر. بسبب طريقة عمل برامج الترميز الصوتية الحديثة، مثل MP3 وAAC، غالبًا ما نفقد اليوم هذه التجربة السمعية السلسة.
سنتناول تفاصيل الأسباب أدناه، ولكن لنبدأ الآن بعرض توضيحي. في ما يلي أول ثلاثين ثانية من فيلم Sintel الرائع مقسّمة إلى خمسة ملفات MP3 منفصلة وتمت إعادة تجميعها باستخدام MSE. تشير الخطوط الحمراء إلى الفجوات التي تم إدخالها أثناء إنشاء (ترميز) كل ملف MP3، وستسمع أخطاء في هذه النقاط.
مقزّز! هذه ليست تجربة رائعة، ويمكننا تقديم ما هو أفضل. مع القليل من العمل الإضافي، باستخدام ملفات MP3 نفسها في العرض التوضيحي أعلاه، يمكننا استخدام MSE لإزالة تلك الفجوات المزعجة. تشير الخطوط الخضراء في العرض التوضيحي التالي إلى مكان ضم الملفات وإزالة الفجوات. على الإصدار 38 من Chrome والإصدارات الأحدث، سيتم تشغيل هذا المحتوى بسلاسة.
تتوفّر طرق متنوّعة لإنشاء محتوى متواصل. لأغراض هذا العرض التوضيحي، سنركز على نوع الملفات التي قد يمتلكها المستخدم العادي. حيث تم ترميز كل ملف بشكل منفصل دون مراعاة المقاطع الصوتية قبله أو بعده.
الإعداد الأساسي
أولاً، لنرجع إلى الوراء ونغطي الإعداد الأساسي لمثيل MediaSource.
"إضافات مصدر الوسائط"، كما يوحي الاسم، هي مجرد إضافات لعناصر الوسائط الحالية. في ما يلي، نعيّن
Object URL،
الذي يمثّل مثيل MediaSource، لسمة المصدر لعنصر
صوتي، تمامًا كما يتم ضبط عنوان URL عادي.
var audio = document.createElement('audio');
var mediaSource = new MediaSource();
var SEGMENTS = 5;

mediaSource.addEventListener('sourceopen', function () {
  var sourceBuffer = mediaSource.addSourceBuffer('audio/mpeg');

  function onAudioLoaded(data, index) {
    // Append the ArrayBuffer data into our new SourceBuffer.
    sourceBuffer.appendBuffer(data);
  }

  // Retrieve an audio segment via XHR.  For simplicity, we're retrieving the
  // entire segment at once, but we could also retrieve it in chunks and append
  // each chunk separately.  MSE will take care of assembling the pieces.
  GET('sintel/sintel_0.mp3', function (data) {
    onAudioLoaded(data, 0);
  });
});

audio.src = URL.createObjectURL(mediaSource);
بعد ربط عنصر MediaSource، سيتم إجراء بعض عمليات الإعداد
وفي النهاية سيتم تنشيط حدث sourceopen، وعند هذه النقطة يمكننا إنشاء
SourceBuffer. في
المثال أعلاه، ننشئ عنصر audio/mpeg يمكنه تحليل وفك
ترميز مقاطع MP3. وهناك عدة
أنواع أخرى متاحة.
أشكال موجية شاذة
سنعود إلى الرمز بعد قليل، ولكن دعونا الآن نلقي نظرة فاحصة على
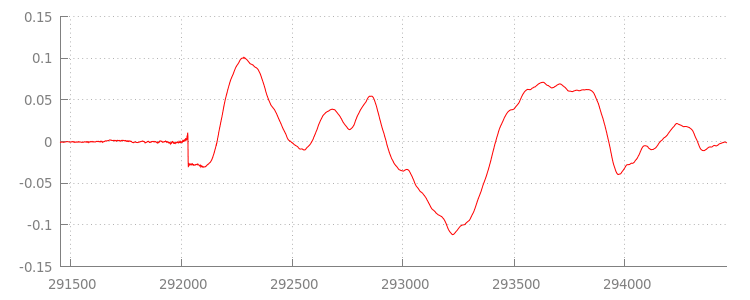
الملف الذي أضفناه للتو، وتحديدًا في نهايته. في ما يلي رسم بياني لآخر 3, 000 عيّنة تم حساب متوسطها على مستوى القناتَين من المقطع الصوتي
sintel_0.mp3. كل بكسل على الخط الأحمر هو
عينة نقطة عائمة
في نطاق [-1.0, 1.0].

ماذا عن كل هذه العينات الصفرية (الصامتة)؟ بل هي ناتجة عن عيوب الضغط التي تحدث أثناء الترميز. يضيف كل برنامج ترميز تقريبًا نوعًا من الحشو. في هذه الحالة، أضاف LAME بالضبط 576 عيّنة حشو إلى نهاية الملف.
بالإضافة إلى المساحة المتروكة في النهاية، تمت إضافة مساحة متروكة في بداية كل ملف أيضًا. إذا ألقينا نظرة على المقطع الصوتي
sintel_1.mp3، سنرى 576 عيّنة أخرى من المساحة المتروكة في البداية. يختلف مقدار
الحشو حسب برنامج الترميز والمحتوى، ولكننا نعرف القيم الدقيقة استنادًا إلى
metadata المضمّنة في كل ملف.
أقسام الصمت في بداية ونهاية كل ملف هي ما يسبب
الأخطاء بين المقاطع في العرض التوضيحي السابق. لتحقيق تشغيل سلس،
نحتاج إلى إزالة هذه الأقسام من الصمت. لحسن الحظ، يمكن إجراء ذلك بسهولة باستخدام
MediaSource. في ما يلي، سنعدّل طريقة onAudioLoaded() لاستخدام
نافذة إلحاق وإزاحة
الطابع الزمني لإزالة هذا الصمت.
مثال على الرمز
function onAudioLoaded(data, index) {
  // Parsing gapless metadata is unfortunately non trivial and a bit messy, so
  // we'll glaze over it here; see the appendix for details.
  // ParseGaplessData() will return a dictionary with two elements:
  //
  //    audioDuration: Duration in seconds of all non-padding audio.
  //    frontPaddingDuration: Duration in seconds of the front padding.
  //
  var gaplessMetadata = ParseGaplessData(data);

  // Each appended segment must be appended relative to the next.  To avoid any
  // overlaps, we'll use the end timestamp of the last append as the starting
  // point for our next append or zero if we haven't appended anything yet.
  var appendTime = index > 0 ? sourceBuffer.buffered.end(0) : 0;

  // Simply put, an append window allows you to trim off audio (or video) frames
  // which fall outside of a specified time range.  Here, we'll use the end of
  // our last append as the start of our append window and the end of the real
  // audio data for this segment as the end of our append window.
  sourceBuffer.appendWindowStart = appendTime;
  sourceBuffer.appendWindowEnd = appendTime + gaplessMetadata.audioDuration;

  // The timestampOffset field essentially tells MediaSource where in the media
  // timeline the data given to appendBuffer() should be placed.  I.e., if the
  // timestampOffset is 1 second, the appended data will start 1 second into
  // playback.
  //
  // MediaSource requires that the media timeline starts from time zero, so we
  // need to ensure that the data left after filtering by the append window
  // starts at time zero.  We'll do this by shifting all of the padding we want
  // to discard before our append time (and thus, before our append window).
  sourceBuffer.timestampOffset =
    appendTime - gaplessMetadata.frontPaddingDuration;

  // When appendBuffer() completes, it will fire an updateend event signaling
  // that it's okay to append another segment of media.  Here, we'll chain the
  // append for the next segment to the completion of our current append.
  if (index == 0) {
    sourceBuffer.addEventListener('updateend', function () {
      if (++index < SEGMENTS) {
        GET('sintel/sintel_' + index + '.mp3', function (data) {
          onAudioLoaded(data, index);
        });
      } else {
        // We've loaded all available segments, so tell MediaSource there are no
        // more buffers which will be appended.
        mediaSource.endOfStream();
        URL.revokeObjectURL(audio.src);
      }
    });
  }

  // appendBuffer() will now use the timestamp offset and append window settings
  // to filter and timestamp the data we're appending.
  //
  // Note: While this demo uses very little memory, more complex use cases need
  // to be careful about memory usage or garbage collection may remove ranges of
  // media in unexpected places.
  sourceBuffer.appendBuffer(data);
}
شكل موجي سلس
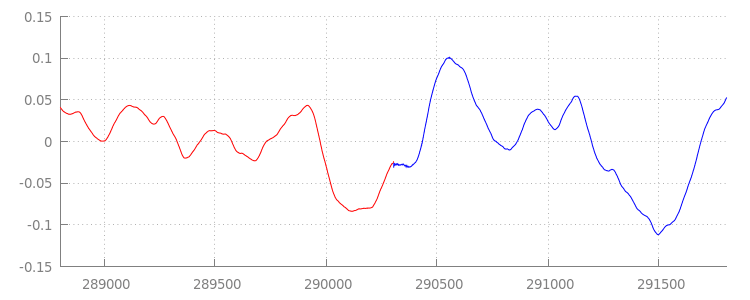
لنرى ما حققه الكود الجديد اللامع من خلال إلقاء نظرة أخرى على الشكل الموجي بعد أن طبقنا نوافذ الإلحاق. في ما يلي، يمكنك ملاحظة أنّه تمت إزالة الجزء الصامت في نهاية
sintel_0.mp3
(باللون الأحمر) والجزء الصامت في بداية
sintel_1.mp3
(باللون الأزرق)، ما يتيح لنا الانتقال بسلاسة بين
المقاطع.
الخاتمة
بهذا نكون قد دمجنا المقاطع الخمسة بسلاسة في مقطع واحد،
ووصلنا إلى نهاية العرض التوضيحي. قبل أن نذهب، ربما لاحظت أن طريقة onAudioLoaded() لدينا لا تأخذ في الاعتبار الحاويات أو برامج الترميز.
هذا يعني أنّ كل هذه الأساليب ستعمل بغض النظر عن نوع الحاوية أو برنامج الترميز. يمكنك أدناه إعادة تشغيل ملف MP4 الأصلي المجزّأ والمتوافق مع DASH بدلاً من MP3.
إذا أردت معرفة المزيد، يمكنك الاطّلاع على الملحقات أدناه للحصول على نظرة أعمق على
إنشاء المحتوى بدون فواصل وتحليل البيانات الوصفية. يمكنك أيضًا استكشاف
gapless.js لإلقاء نظرة عن كثب على
الرمز البرمجي الذي يشغّل هذا العرض التوضيحي.
شكرًا على القراءة.
الملحق "أ": إنشاء محتوى بدون فواصل
قد يكون من الصعب إنشاء محتوى متواصل. في ما يلي، سنتعرّف على كيفية إنشاء وسائط Sintel المستخدَمة في هذا العرض التوضيحي. للبدء، ستحتاج إلى نسخة من الموسيقى التصويرية بتنسيق FLAC بدون فقدان البيانات لفيلم Sintel. وللأجيال القادمة، تم تضمين SHA1 أدناه. بالنسبة إلى الأدوات، ستحتاج إلى FFmpeg وMP4Box وLAME وتثبيت OSX مع afconvert.
    unzip Jan_Morgenstern-Sintel-FLAC.zip
    sha1sum 1-Snow_Fight.flac
    # 0535ca207ccba70d538f7324916a3f1a3d550194  1-Snow_Fight.flac
أولاً، سنفصل أول 31.5 ثانية من المقطع الصوتي "1-Snow_Fight.flac". نريد أيضًا إضافة تلاشٍ لمدة 2.5 ثانية بدءًا من 28 ثانية لتجنب أي نقرات بمجرد انتهاء التشغيل. باستخدام سطر أوامر FFmpeg أدناه، يمكننا
إنجاز كل ذلك ووضع النتائج في sintel.flac.
ffmpeg -i 1-Snow_Fight.flac -t 31.5 -af "afade=t=out:st=28:d=2.5" sintel.flac
بعد ذلك، سنقسّم الملف إلى 5 ملفات wave
مدّة كل منها 6.5 ثوانٍ. من الأسهل استخدام ملفات wave لأنّ معظم برامج الترميز
تتيح تحميلها. يمكننا تنفيذ ذلك بدقة باستخدام FFmpeg،
وبعد ذلك سنحصل على: sintel_0.wav وsintel_1.wav وsintel_2.wav
وsintel_3.wav وsintel_4.wav.
    ffmpeg -i sintel.flac -acodec pcm_f32le -map 0 -f segment \
           -segment_list out.list -segment_time 6.5 sintel_%d.wav
بعد ذلك، لننشئ ملفات MP3. يتضمّن LAME عدة خيارات لإنشاء محتوى
بلا فواصل. إذا كنت تتحكّم في المحتوى، يمكنك استخدام --nogap مع ترميز مجمّع لجميع الملفات لتجنُّب إضافة مساحة متروكة بين المقاطع تمامًا.
ولكن لأغراض هذا العرض التوضيحي، نريد هذا الحشو، لذا سنستخدم
ترميز VBR عالي الجودة لملفات wave.
    lame -V=2 sintel_0.wav sintel_0.mp3
    lame -V=2 sintel_1.wav sintel_1.mp3
    lame -V=2 sintel_2.wav sintel_2.mp3
    lame -V=2 sintel_3.wav sintel_3.mp3
    lame -V=2 sintel_4.wav sintel_4.mp3
هذا كل ما هو ضروري لإنشاء ملفات MP3. والآن، لنتعرّف على كيفية إنشاء ملفات MP4 مجزّأة. سنتبع توجيهات Apple لإنشاء وسائط مُعدّة لـ iTunes. في ما يلي، سنحوّل ملفات wave إلى ملفات CAF وسيطة وفقًا للتعليمات، قبل ترميزها كملفات AAC في حاوية MP4 باستخدام المَعلمات المقترَحة.
    afconvert sintel_0.wav sintel_0_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_1.wav sintel_1_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_2.wav sintel_2_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_3.wav sintel_3_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_4.wav sintel_4_intermediate.caf -d 0 -f caff \
              --soundcheck-generate
    afconvert sintel_0_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_0.m4a
    afconvert sintel_1_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_1.m4a
    afconvert sintel_2_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_2.m4a
    afconvert sintel_3_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_3.m4a
    afconvert sintel_4_intermediate.caf -d aac -f m4af -u pgcm 2 --soundcheck-read \
              -b 256000 -q 127 -s 2 sintel_4.m4a
لدينا الآن عدة ملفات M4A نحتاج إلى
تقسيمها
بشكل مناسب قبل استخدامها مع
MediaSource. لأغراضنا، سنستخدم حجم جزء مدته ثانية واحدة. سيكتب MP4Box
كل ملف MP4 مجزّأ على شكل sintel_#_dashinit.mp4 مع
ملف بيان MPEG-DASH (sintel_#_dash.mpd) يمكن تجاهله.
    MP4Box -dash 1000 sintel_0.m4a && mv sintel_0_dashinit.mp4 sintel_0.mp4
    MP4Box -dash 1000 sintel_1.m4a && mv sintel_1_dashinit.mp4 sintel_1.mp4
    MP4Box -dash 1000 sintel_2.m4a && mv sintel_2_dashinit.mp4 sintel_2.mp4
    MP4Box -dash 1000 sintel_3.m4a && mv sintel_3_dashinit.mp4 sintel_3.mp4
    MP4Box -dash 1000 sintel_4.m4a && mv sintel_4_dashinit.mp4 sintel_4.mp4
    rm sintel_{0,1,2,3,4}_dash.mpd
هذا كل شيء! لدينا الآن ملفات MP4 وMP3 مجزّأة تحتوي على البيانات الوصفية الصحيحة اللازمة للتشغيل المتواصل. راجع الملحق ب لمزيد من التفاصيل حول شكل تلك البيانات الوصفية.
الملحق ب: تحليل البيانات الوصفية التي تتيح التشغيل المتواصل
تمامًا مثل إنشاء محتوى بلا فواصل، قد يكون تحليل البيانات الوصفية بلا فواصل أمرًا صعبًا نظرًا لعدم توفّر طريقة عادية للتخزين. سنشرح في ما يلي كيفية تخزين البيانات الوصفية المتواصلة في برنامجي الترميز الأكثر شيوعًا، وهما LAME وiTunes. لنبدأ بإعداد بعض الطرق المساعدة ومخطط تفصيلي لـ ParseGaplessData() المستخدم أعلاه.
    // Since most MP3 encoders store the gapless metadata in binary, we'll need a
    // method for turning bytes into integers.  Note: This doesn't work for values
    // larger than 2^30 since we'll overflow the signed integer type when shifting.
    function ReadInt(buffer) {
      var result = buffer.charCodeAt(0);
      for (var i = 1; i < buffer.length; ++i) {
        result <<= 8;
        result += buffer.charCodeAt(i);
      }
      return result;
    }

    function ParseGaplessData(arrayBuffer) {
      // Gapless data is generally within the first 512 bytes, so limit parsing.
      var byteStr = new TextDecoder().decode(arrayBuffer.slice(0, 512));

      var frontPadding = 0, endPadding = 0, realSamples = 0;

      // ... we'll fill this in as we go below.
سنبدأ بتنسيق البيانات الوصفية في Apple iTunes لأنّه الأسهل في التحليل والشرح. في ملفات MP3 وM4A، يكتب iTunes (وafconvert) قسمًا قصيرًا في ASCII على النحو التالي:
iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00
تتم كتابة هذه البيانات داخل علامة ID3 ضمن حاوية MP3 وداخل عنصر بيانات وصفية
ضمن حاوية MP4. لأغراضنا، يمكننا تجاهل الرمز المميّز الأول 0000000. الرموز الثلاثة التالية هي الحشو الأمامي والحشو النهائي
وإجمالي عدد العينات غير المخصصة للحشو. وبقسمة كل من هذه القيم على معدّل البيانات في الملف الصوتي،
نحصل على مدة كل منها.
// iTunes encodes the gapless data as hex strings like so:
//
//    'iTunSMPB[ 26 bytes ]0000000 00000840 000001C0 0000000000046E00'
//    'iTunSMPB[ 26 bytes ]####### frontpad  endpad    real samples'
//
// The approach here elides the complexity of actually parsing MP4 atoms. It
// may not work for all files without some tweaks.
var iTunesDataIndex = byteStr.indexOf('iTunSMPB');
if (iTunesDataIndex != -1) {
  var frontPaddingIndex = iTunesDataIndex + 34;
  frontPadding = parseInt(byteStr.substr(frontPaddingIndex, 8), 16);

  var endPaddingIndex = frontPaddingIndex + 9;
  endPadding = parseInt(byteStr.substr(endPaddingIndex, 8), 16);

  var sampleCountIndex = endPaddingIndex + 9;
  realSamples = parseInt(byteStr.substr(sampleCountIndex, 16), 16);
}
في المقابل، تخزّن معظم برامج ترميز MP3 المفتوحة المصدر البيانات الوصفية للتشغيل المتواصل ضمن عنوان Xing خاص يتم وضعه داخل إطار MPEG صامت (يكون صامتًا لكي تشغّل برامج فك الترميز التي لا تفهم عنوان Xing مقطعًا صامتًا). للأسف، لا تتوفّر هذه العلامة دائمًا، وتتضمّن عددًا من الحقول الاختيارية. لأغراض هذا العرض التوضيحي، لدينا إمكانية التحكّم في الوسائط، ولكن من الناحية العملية، ستكون هناك حاجة إلى بعض عمليات التحقّق الإضافية من الحساسية لمعرفة متى تكون البيانات الوصفية السلسة متاحة فعليًا.
أولاً، سنحلّل إجمالي عدد العيّنات. لتبسيط الأمر، سنقرأ هذه المعلومات من
رأس Xing، ولكن يمكن إنشاؤها من
رأس صوت MPEG العادي.
يمكن وضع علامة Xing أو Info على عناوين Xing. بعد هذه العلامة، هناك 32 بت تمثّل إجمالي عدد الإطارات في الملف. وعند ضرب هذه القيمة بعدد العينات لكل إطار، سنحصل على إجمالي العينات في الملف.
    // Xing padding is encoded as 24bits within the header.  Note: This code will
    // only work for Layer3 Version 1 and Layer2 MP3 files with XING frame counts
    // and gapless information.  See the following document for more details:
    // http://www.codeproject.com/Articles/8295/MPEG-Audio-Frame-Header
    var xingDataIndex = byteStr.indexOf('Xing');
    if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Info');
    if (xingDataIndex != -1) {
      // See section 2.3.1 in the link above for the specifics on parsing the Xing
      // frame count.
      var frameCountIndex = xingDataIndex + 8;
      var frameCount = ReadInt(byteStr.substr(frameCountIndex, 4));

      // For Layer3 Version 1 and Layer2 there are 1152 samples per frame.  See
      // section 2.1.5 in the link above for more details.
      var paddedSamples = frameCount * 1152;

      // ... we'll cover this below.
الآن بعد أن حصلنا على إجمالي عدد العينات، يمكننا الانتقال إلى قراءة عدد عينات المساحة المتروكة. استنادًا إلى برنامج الترميز، قد تتم كتابة هذه المعلومات ضمن علامة LAME أو Lavf مضمّنة في عنوان Xing. بعد 17 بايت بالضبط من هذا العنوان، هناك 3 بايت تمثّل المساحة المتروكة في الأمام والنهاية في 12 بت لكل منها على التوالي.
        xingDataIndex = byteStr.indexOf('LAME');
        if (xingDataIndex == -1) xingDataIndex = byteStr.indexOf('Lavf');
        if (xingDataIndex != -1) {
          // See http://gabriel.mp3-tech.org/mp3infotag.html#delays for details of
          // how this information is encoded and parsed.
          var gaplessDataIndex = xingDataIndex + 21;
          var gaplessBits = ReadInt(byteStr.substr(gaplessDataIndex, 3));

          // Upper 12 bits are the front padding, lower are the end padding.
          frontPadding = gaplessBits >> 12;
          endPadding = gaplessBits & 0xFFF;
        }

        realSamples = paddedSamples - (frontPadding + endPadding);
      }

      return {
        audioDuration: realSamples * SECONDS_PER_SAMPLE,
        frontPaddingDuration: frontPadding * SECONDS_PER_SAMPLE
      };
    }
وبذلك، نكون قد حصلنا على دالة كاملة لتحليل الغالبية العظمى من المحتوى الذي لا يتضمّن فجوات. ومع ذلك، هناك بالتأكيد الكثير من الحالات الهامشية، لذا يُنصح بالحذر قبل استخدام رمز مماثل في مرحلة الإنتاج.
الملحق "ج": جمع البيانات غير المستخدَمة
يتم بشكل نشط جمع المهملات من الذاكرة التي تنتمي إلى مثيلات SourceBuffer وفقًا لنوع المحتوى والحدود الخاصة بالمنصة وموضع التشغيل الحالي. في Chrome، سيتم أولاً استرداد الذاكرة من المخازن المؤقتة التي سبق تشغيلها.
ومع ذلك، إذا تجاوز استخدام الذاكرة الحدود الخاصة بالمنصة، ستتم إزالة الذاكرة
من المخازن المؤقتة غير المشغَّلة.
عندما يصل التشغيل إلى فجوة في المخطط الزمني بسبب الذاكرة المستردّة، قد يحدث خلل إذا كانت الفجوة صغيرة بما يكفي أو يتوقف تمامًا إذا كانت الفجوة كبيرة جدًا. ولا يوفّر أي منهما تجربة مستخدم رائعة، لذا من المهم تجنُّب إلحاق الكثير من البيانات في آنٍ واحد وإزالة النطاقات يدويًا من المخطط الزمني للوسائط التي لم تعد ضرورية.
يمكن إزالة النطاقات من خلال طريقة
remove()
في كل SourceBuffer، والتي تستخدم نطاق [start, end] بالثواني.
على غرار appendBuffer()، سيؤدي كل remove() إلى تنشيط حدث updateend مرة واحدة عند اكتماله. يجب عدم إصدار عمليات إزالة أو إلحاق أخرى إلى أن يتم تشغيل الحدث.
في إصدار Chrome لأجهزة الكمبيوتر المكتبي، يمكنك الاحتفاظ بحوالي 12 ميغابايت من المحتوى الصوتي و150 ميغابايت من محتوى الفيديو في الذاكرة في آن واحد. يجب عدم الاعتماد على هذه القيم في جميع المتصفحات أو الأنظمة الأساسية، على سبيل المثال، من المؤكد أنها لا تمثل الأجهزة الجوّالة.
لا تؤثر عملية جمع المهملات إلا في البيانات التي تتم إضافتها إلى SourceBuffers، ولا توجد حدود لمقدار البيانات التي يمكنك الاحتفاظ بها في ذاكرة التخزين المؤقت في متغيّرات JavaScript. يمكنك أيضًا إعادة إلحاق البيانات نفسها في الموضع نفسه إذا لزم الأمر.